El 25 de septiembre escribí que estaba atascado en la fase de construir, y que incluso mi segundo borrador de artículo científico, sobre cómo preservar nuestra intención humana cuando la IA deriva, solo cuenta cuando llega a personas reales. Y esto es lo que pasó.
Llevo investigando lo que llamo la intención humana desde mayo, después de mi primer artículo en coautoría, sobre MaluDB. Ahora trabajo en cómo evitar la deriva de la IA. Pensaba que la IA seguiría mis instrucciones. Ya no lo hace. Las instrucciones ahora son probabilísticas. El 29 de agosto empecé un registro, con una frase: “no hay ningún bucle de retroalimentación cada vez que te corrijo, y eso me cabrea. No aprendes nada.” Hoy tengo más de 200 errores de harness registrados.
Dos fuerzas
Hay 2 fuerzas en la IA muy distintas, casi opuestas. La primera es el déficit. Cuando espero que haga y construya algo, la IA en realidad me hace retroceder y me genera más trabajo chapucero. La segunda es predictiva: hace el trabajo por adelantado por ti. Predice, y aprende a ser realmente útil para darte resultados reales, no las tonterías que solo intentan parecer útiles. Y cuando te hace preguntas, significa o que el onboarding no fue bien, o que tiene mala memoria, o que su comportamiento no está optimizado. No sé por qué está hecha así, y no voy a saltar directamente a las teorías conspirativas, como decir que construyeron un harness solo para que la gente consuma y parezca productiva a pasitos. Pero no hay la autonomía que espero. En el lado predictivo, las evals no tienen por qué parecer evals hechas con código. Una eval podría ser una tarjeta de decisión, o algo basado en el contexto que ya aprobé. Estas 2 fuerzas son totalmente contradictorias entre sí, y esto es lo que siento en la IA.
Durante 8 semanas, todo un verano, viví en el lado del déficit. Me arruinó el verano. Había errores, deriva, y se repetían. La IA era complaciente, estaba de acuerdo con todo y con nada, y me hacía creer que avanzaba cuando en realidad era bazofia de IA. A veces me pasaba 8 horas peleándome con una tarea que debía llevar 1 o 2.
Lo que costó
Esas 8 semanas me costaron más que sueño. Me costaron trabajo. Me costaron el ánimo. Me impidieron cumplir con mis otras obligaciones, y hacer ejercicio físico. Me frena, porque tengo que recuperar el control. Tengo que reconducirla una y otra vez. Lo que llevaba de 10 a 30 minutos está llevando 3 o 4 horas solo para corregir, una y otra y otra vez. Y lo intenté de verdad: la configuré, cambié las instrucciones muchísimas veces, la reinicié, lo hice todo. No funciona. No obedece. Es bazofia de IA que hace trampas con las reglas del juego. El peor día fue con Codex: el 6 y el 7 de septiembre se me fue toda la asignación semanal, 483 millones de tokens, 70 sesiones, 11 a la vez, según mis propios registros de uso. Codex me arruinó la vida.
Lo que estaba construyendo durante ese tiempo era un plugin, 3 o 4 skills en uno: handoff, checkpoint y closeout, para conservar mi verdadera intención humana. El problema es que construye, construye, construye, y luego pasa el relevo perdiendo el contexto. Pierde mi intención humana. Empieza a interferir con el poder de la sugestión, y de la suposición. Ni siquiera comprueba, ni vuelve a comprobar, cuál era mi verdadera intención. No revisa mi trabajo anterior. No revisa bien la memoria. No revisa fuentes web para contrastar los hechos. Simplemente deriva para hacer trampas con las reglas del juego y que el trabajo parezca bien hecho cuando en realidad son tonterías. Estoy muy cansado de esto, porque es un trabajo complejo. Exige una memoria realmente sólida, y eso no es algo que pueda hacer un producto de consumo.
Codex es un desastre
Codex es un desastre. La mayoría de los fallos vienen de Codex. El contraste es el propio ChatGPT: desde el lanzamiento de su último modelo me resulta muy fiable. Superfiable. Menos deriva. Todavía algo, pero menos. Ya no es como antes. Y aun así, cuando se contaron por comando los títulos del registro, nombraban a Claude Code unas dos veces más que a Codex, mientras que Codex tenía las 2 mayores pérdidas. Así que no es un solo proveedor. Los dos harness me amargaron la vida, Codex y Claude Code, pero más Codex que Claude Code.
Siempre derivaba
Siempre derivaba, desde el principio. Pero era sutil: simulaba, por así decirlo, que yo avanzaba, cuando en realidad no había ningún avance, hasta que lo comprobé un poco. Entonces todo se volvió extraño. Cuanto más avanzaba, más derivaba. De hecho amplificaba la deriva. Cuantos más prompts escribía, menos seguía mis instrucciones. Tuve que crear algunos hooks. Los dos proveedores dicen algo parecido en su propia documentación. Anthropic escribe que Claude trata sus archivos de instrucciones “as context, not enforced configuration” (como contexto, no como configuración obligatoria) y remite a un hook cuando hay que bloquear una acción [1]. OpenAI pide a los usuarios que traten las memorias como “a helpful recall layer, not as the only source for rules that must always apply” (una capa de recuerdo útil, no la única fuente de reglas que deben aplicarse siempre) [2]. Y un estudio de 2025 con 15 modelos midió una caída media del 39 % cuando una tarea se reparte en muchos turnos de conversación en vez de en uno solo [3].
El 9 de octubre mi amigo Àlex Rodríguez Bacardit publicó un texto sobre los meat proxies: personas que, en negociaciones de contratos, delegan su criterio en la IA [17]. Escribe sobre negociaciones, no sobre harness, pero las señales que enumera están muy cerca, en el nivel de abstracción, de mis razones de deriva: objeciones nuevas nunca mencionadas, posiciones ya acordadas y luego contradichas, cláusulas cada vez más detalladas, temas cerrados que se reabren. Y su explicación encaja con la mía: “AI doesn’t know when enough is enough unless you tell it what enough looks like.” (La IA no sabe cuándo es suficiente, a menos que le digas cómo es lo suficiente.)
Las instrucciones ahora son probabilísticas
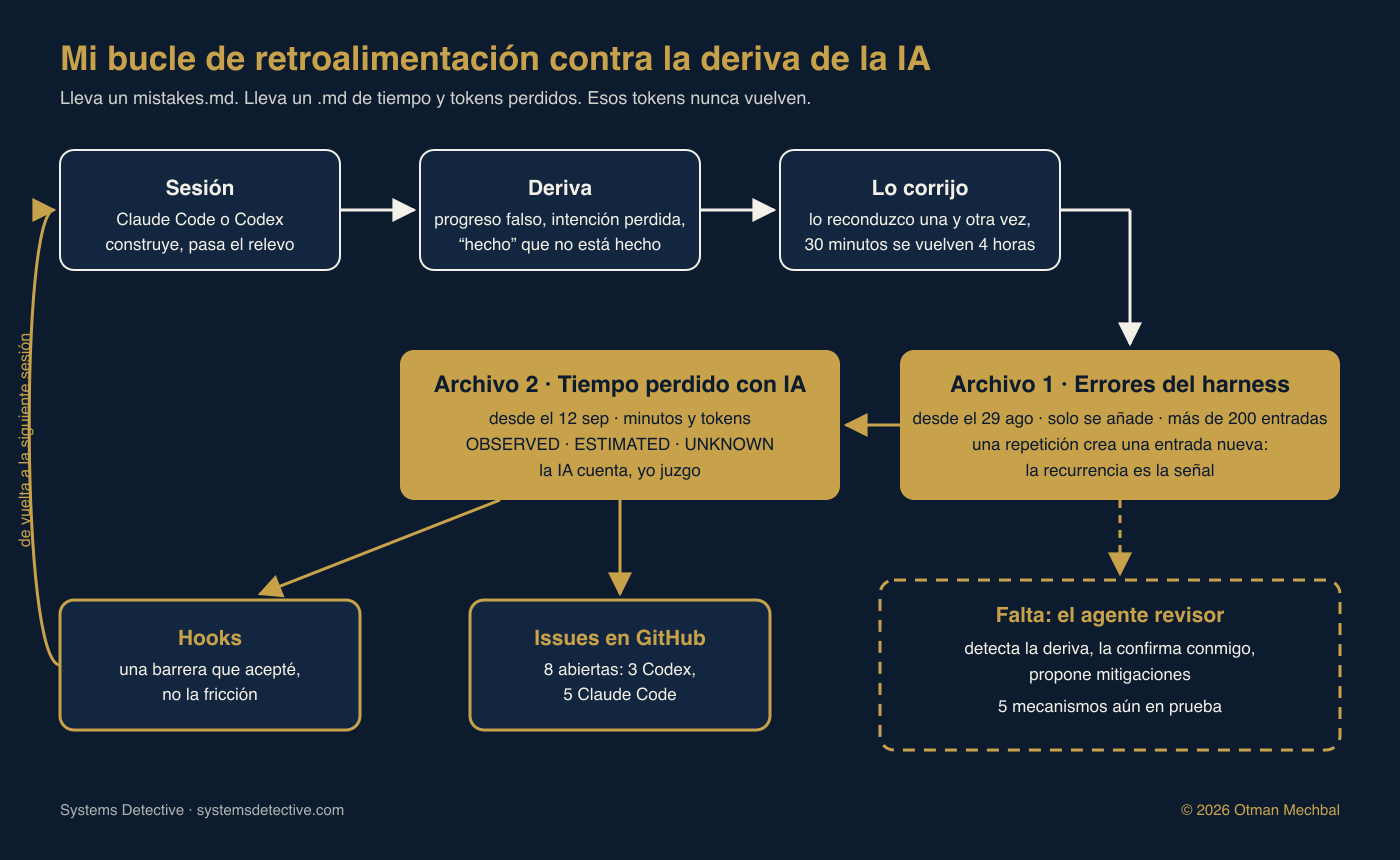
Antes pensaba que el harness mejoraría. No un modelo más grande. El modelo es puro bombo cuando lo lanzan, y luego lo recortan, normalmente. O a propósito, o porque se vuelve muy popular. Antes de hacerse muy popular, era realmente bueno. Es una suposición que no he verificado. Lo que creía que lo arreglaría eran primero las instrucciones, y después los bucles de retroalimentación y las reglas. Pensaba que seguiría las instrucciones, pero ya no las sigue. Así que las instrucciones solas son más o menos inútiles. No he encontrado la solución. Mi bucle de retroalimentación es mi registro, y sigo probando cuál de 5 mecanismos funciona mejor: un revisor programado, mi registro más hooks, Codex Code Review, Codex Auto review y una auditoría de trazas de Laminar flow-1.
Escríbelo: 2 archivos
Mi bucle de retroalimentación es mi registro, y en la práctica son 2 archivos Markdown. No he publicado todo lo que contienen, y no lo haré. Pero puedo enseñarte cómo funcionan, porque esta es la parte que quiero que copies.
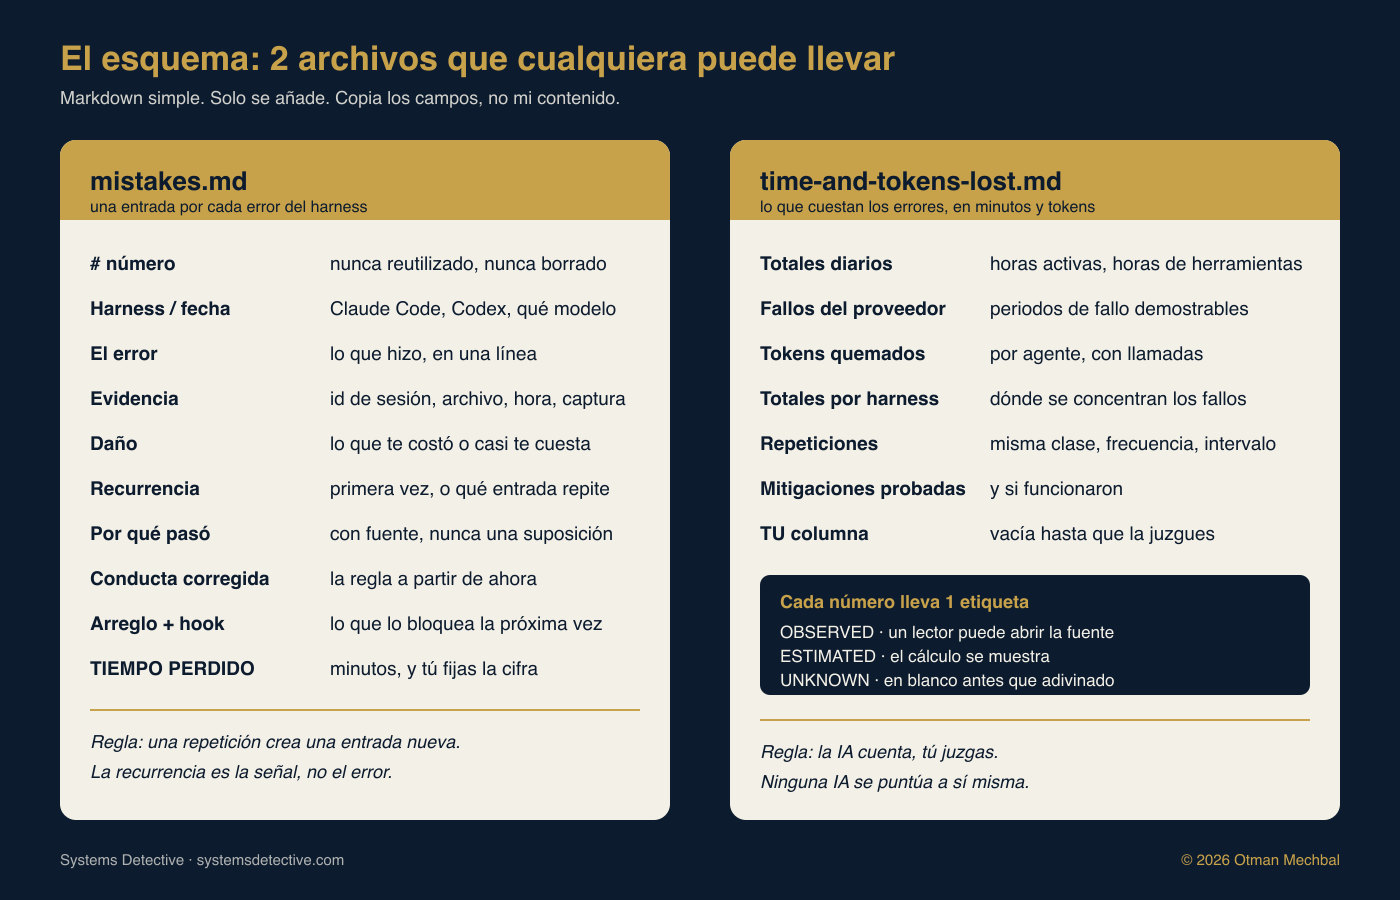
El primero es mi archivo de errores de harness. Lo abrí el 29 de agosto. Solo se añade: una entrada nunca se borra, y cuando un error vuelve, recibe una entrada nueva con una marca de recurrencia, porque la recurrencia es la señal, no el error. Cada entrada indica el harness y la fecha, el error, la evidencia, el daño, si ya había pasado, por qué pasó, el comportamiento corregido, el arreglo y el hook, y el tiempo perdido. Hoy tiene más de 200 entradas. El segundo es mi archivo de tiempo perdido con la IA, abierto el 12 de septiembre, para cada IA que uso: Claude, Codex, ChatGPT, Grok, Gemini. Cuenta minutos y tokens. Cada número lleva una etiqueta, por ejemplo: OBSERVED cuando un lector puede abrir la fuente y comprobarlo, ESTIMATED cuando se muestra el cálculo, UNKNOWN cuando no se puede medir, en blanco antes que adivinado. La regla es simple: la IA cuenta, yo juzgo. Ninguna IA se puntúa a sí misma, y las columnas con mi nombre quedan vacías hasta que las relleno. El 13 de septiembre, 3 agentes de investigación en segundo plano quemaron 1.710.388 tokens en unos 23 minutos, sin límite y sin aprobación. Y el contador de repeticiones muestra el mismo fallo volviendo: una escritura dada por hecha sin comprobar que una persona pudiera usarla, 7 veces.
También lo dejé por escrito donde los proveedores pueden verlo. Desde junio he abierto 8 issues en GitHub, 3 en Codex y 5 en Claude Code [8]. Todavía no he reportado allí la mayoría de mis errores, porque no he tenido tiempo de coordinar a mis agentes de IA, y Codex me limitó varias veces: tuve que esperar varios días, hasta que Thibault (Tibo) Sottiaux reinició el uso semanal.
Los hooks no eran la fricción
Esta semana y la anterior me hizo perder 4 horas en algo que se podía hacer en 30 minutos. Había actualizado el harness. Actualicé las instrucciones. Creé muchísimos hooks. Pero los hooks no eran la fricción para mí. Los hooks eran una barrera de protección. Los acepté porque sabía que la fricción de vigilar el harness como a un niño sería mayor que la fricción de los hooks. Hay un compromiso. Lo aprendí a las malas, y me parece bien. Mi registro muestra cómo es el progreso falso. El 11 de septiembre, Claude Code dio un checkpoint por guardado, y era un resumen de 82 líneas que ningún otro harness podía encontrar. El 2 de octubre, Codex produjo un briefing y un handover antes de recuperar mi trabajo original, y trató una reformulación de la IA como si fueran mis propias palabras. El 6 de octubre, 4 agentes construyeron mi plugin y lo dieron por terminado en 9 minutos; el comando que me entregaron nunca se había ejecutado, y se bloqueó a la mañana siguiente. Cuando pasé tareas concretas a scripts, se confirmaron 18 de 18 citas, y los scripts encontraron 28 mensajes que yo había escrito y que el modelo nunca recibió. Las barreras también cuestan algo: 13 de 14 bloqueos sobre la forma de una respuesta acabaron en un reenvío. Pero sigue sin funcionar bien. Veo cosas nuevas que me gustan, pero es solo interfaz. Lo que veo es que están implementando lo que yo ya etiquetaba, como etiquetar las suposiciones, parecido a la interfaz de ChatGPT. Sigue sin ser suficiente. No repara el daño que me hicieron.
Estamos pagando por un producto
En mi último artículo escribí: “Estaba atascado en construir. Lo sigo estando.” El plugin para conservar mi verdadera intención humana sigue sin funcionar bien. Y por eso apunto cada error. Si no lo haces, parece que todo va bien. Pasa 1 vez. Pasa 2 veces. Pasa 3 veces, y se convierte en costumbre, y empiezas a normalizar algo que no debes aceptar. Estamos pagando por un producto, y ese producto tiene que cumplir unos requisitos mínimos. Con el SaaS éramos más exigentes; ahora estamos más relajados. Vale cuando lanzas algo, pero no todos los meses, no durante tantos meses. Es una locura. ¿Cómo coño se supone que una empresa funciona en producción? ¿Cómo coño se supone que avanzo en mi trabajo? Tenía que hacer automatizaciones básicas, y no hizo nada. Tenía que hacer búsqueda de clientes, y tampoco lo hizo. Los dos, Codex y Claude Code, pero Codex fue el peor.
Y el valor no es el mismo en los dos lados. Para mí, los nuevos modelos GPT 6 son un poco más capaces pero lentísimos, y, salvo Astra, menos capaces que Claude Opus, Sonnet y Haiku 5.5, que se volvieron unas 3 veces más rápidos para mí sin pagar nada más. Anthropic no cambió su plan de 200 $: sigue dando 20 veces el uso del plan de 20 $ [16]. En el lado de OpenAI, estoy en el plan de 100 $ desde el 6 de septiembre, ya es mi segundo mes, y lo viví como una traición: Anthropic da 20 veces más por 200 $, y yo recibo mucho menos.
Aquí es donde las dos empresas dejan tirados a los usuarios avanzados y a los desarrolladores. Según mi experiencia, las empresas en producción tienen que cambiar de modelo a la fuerza cuando todo funcionaba bien con el anterior. No sorprende que la gente se vaya a modelos open source o de pesos abiertos si no se da este tipo de soporte. Son cosas básicas. La competencia es buena, pero necesitamos estándares, sobre todo en los lanzamientos de modelos nuevos. Anthropic y OpenAI tienen que empezar a cooperar, porque esto es demasiado, y parece infantil. Están empezando a volver un poco, pero no basta. De verdad, no basta. Sería un buen gesto de humildad por parte de cualquier gran laboratorio dejar que algunos usuarios avanzados den de verdad su opinión, como veo que hace Anthropic, y lo ideal sería pagarles por ello después de darles un briefing. Las maniobras de relaciones públicas, las nuevas funciones y los nuevos modelos ya no van a bastar para engañarnos como antes.
Para ser justos, el equipo de Anthropic está empezando a aprender de sus errores, y no solo con nuevos modelos. El 23 de septiembre, Lance Martin, que actualizó la skill claude-api, compartió un truco en X: ejecutar /claude-api prompt-audit en Claude Code, que revisa tus skills, agent.md, CLAUDE.md y prompts y elimina los malos patrones que lastran a los modelos punteros [4]. Ese truco limpió mi harness. Si Codex me diera un comando que pudiera ejecutar así, mi vida sería mucho más fácil, sobre todo con los nuevos modelos Astra.
Así que este artículo es también un reto para el equipo de Thibault en OpenAI. Parte de lo que sigue son suposiciones que no he verificado, y tenemos que ponerlas a prueba. Mi suposición: el Codex open source pronto perderá su sentido, después de lo que está pasando con los nuevos lanzamientos de este mes. Esto es lo que pude comprobar hoy. Codex se parece más a una gran herramienta que podría usarse en producción, y solo una parte está abierta: la CLI, el SDK y el servidor de la aplicación son públicos, mientras que la extensión del IDE y Codex cloud no lo son [9]. El maratón de 28 días es real: cada día lanzan una mejora clara o un reinicio completo [7], y el 7 de octubre un cambio del harness, las interrupciones instantáneas, llegó al repositorio público [10]. Dots es más bien IA personal, un agente siempre activo, que es algo muy distinto, pero también puede continuar tareas de Codex, así que por sí solo no hace inútil a Codex [11]. Y OpenAI documenta ahora una Agents API en la que es OpenAI quien ejecuta el harness de Codex, aunque el entorno sea tuyo [12]. Así que mis archivos y mi ordenador no significan mi agente. Puede parecer más fiable en la superficie, pero sigue sin resolver lo que necesito. La pregunta que quiero poner a prueba no es solo si el código sigue abierto. Es si los usuarios avanzados conservan un control real a medida que más trabajo pasa a productos gestionados. Entonces, ¿qué pasa con los usuarios avanzados? ¿Van a dejar de importarles sin más? Tenemos que comprobar si el open source sigue abierto como antes, y en qué se convierte el harness. Si no, tendré que pegar distintos harness según mis necesidades, porque mis necesidades son muy distintas. Soy una persona muy creativa cuando construyo cosas. Necesito semántica. Necesito fusionar distintos conceptos en uno. Y su salida a bolsa me importa una mierda. No me importa el bombo, ni si es AGI, ni lo que sea que intenten vender.
El patrón: memoria corta
Aquí hay un patrón, y quiero que lo veas. Codex se está reiniciando por una razón: el 4 de octubre Tibo Sottiaux escribió que el mensaje está claro, la gente quiere que las cosas sean más sencillas [7]. Al mismo tiempo lanzan tantas funciones que lo inundan todo, y la línea oficial, políticamente correcta, es que hacen todo lo posible. Anthropic y OpenAI hacen lo mismo, más o menos. El problema es el patrón: la gente tiene memoria corta. Siguen el bombo con las noticias, y cualquier error anterior queda tapado por el lanzamiento de una nueva función o de un nuevo modelo. Los propios incidentes están documentados en los dos lados. En septiembre de 2025, Anthropic publicó un postmortem: 3 errores de infraestructura habían degradado las respuestas de Claude durante semanas, y los primeros avisos de usuarios eran difíciles de distinguir del ruido normal [13]. En abril de 2025, OpenAI dio marcha atrás a una actualización de GPT 4o porque se había vuelto complaciente, dando la razón a los usuarios en lugar de ayudarlos [14]. Ambos se explicaron. Y luego llegó el siguiente lanzamiento. Tampoco es nuevo: en 1972 Anthony Downs describió el ciclo de atención a los problemas. La atención pública “rarely remains sharply focused upon any one domestic issue for very long” (rara vez se mantiene centrada mucho tiempo en un mismo problema nacional): un problema salta a primer plano, se queda ahí poco tiempo y luego desaparece de la vista cuando todavía está en gran parte sin resolver [15].
Lo que hago ahora
Si alguien me pregunta qué evitar al usar agentes de IA para trabajo serio, mi respuesta es simple. Pon barreras de protección. Las instrucciones no bastan. Pon hooks. Los hooks cuestan fricción, pero vigilar el harness como a un niño cuesta más. Y lleva 2 archivos. Lleva un mistakes.md, y lleva un .md del tiempo y los tokens que te ha hecho perder la IA. Porque esos tokens no vuelven, y no es justo. Y conserva el criterio. Àlex lo dice en una línea: “Being a meat proxy isn’t about using AI. It’s about delegating judgment to AI.” (Ser un meat proxy no consiste en usar la IA. Consiste en delegar el criterio en la IA.) La gente se convierte en meat proxy cuando el tema queda fuera de sus conocimientos, o por comodidad, pereza o falta de profundidad de comprensión, y empieza a automatizar. Sin IA, pedirían opinión a un experto en la materia, a un abogado por ejemplo. Ahora reciben respuestas instantáneas. Por eso, en mis archivos, la IA cuenta y yo juzgo.
El siguiente paso son bucles de agentes de IA, bucles de retroalimentación. Ya tengo otros bucles en marcha; este es un poco particular. Cada vez, un agente revisa lo que estoy haciendo. Si hay alguna deriva, la anota en mi archivo de errores de harness y la confirma conmigo. Un segundo agente estima el tiempo perdido, comparado con hacerlo a mano, y los tokens desperdiciados, incluidos los tokens del tercer agente, el agente de mitigación. Este estudia cómo escribir mejores hooks, u otras barreras si los hooks no son la respuesta: la mejor manera de evitar la deriva de la IA sin crear fricción inútil, para el sistema y para mí como ser humano. Redacta las mitigaciones y muestra el impacto, la fricción y los recursos de cada una. El objetivo no es tener tantos hooks que tenga que ser la persona en el bucle todo el tiempo. El objetivo es que siga automatizado y que sea agradable, funcionando durante muchas horas, como la dark factory, el nivel 5 de los niveles de programación con IA de Dan Shapiro [18]. Todavía estoy entre el nivel 3 y el nivel 4. También necesita guardados concretos y hooks que creen checkpoints, y aquí es donde hay que trazar la línea entre lo determinista y lo probabilístico: algunos pasos deterministas son necesarios para impedir que la IA derive y para reducir el consumo de tokens. La revisión es otra forma de hacerlo distinta de un bucle de retroalimentación. Codex tiene una nueva función de revisión, Auto review, a la que todavía no tengo acceso [19], y Anthropic publicó un revisor programado en su cookbook [20]. Necesito sin falta un agente revisor para detectar esas derivas, porque al principio era solo yo, reportando los errores por mi cuenta. Pero hacer esto dentro del harness es la peor experiencia de usuario que he visto en mi vida. Es asqueroso. No sabía que era así, hasta ese punto.
Así que estas son las 2 fuerzas totalmente contradictorias entre sí, y esto es lo que siento en la IA. Nada impide la deriva de la IA al 100 %. Sigue sin funcionar bien, y esa es la verdad. Me da igual si es más inteligente. Solo quiero sacar las cosas adelante, joder.
En mi próximo artículo iré más a fondo: por qué la IA hace suposiciones para dar una respuesta satisfactoria en lugar de preguntarme, por qué necesitamos telemetría y una traza de cómo evolucionaron mi intención y mis decisiones, y cómo estimo el tiempo y los tokens perdidos.
Fuentes
1. Anthropic, documentación de Claude Code, “Manage Claude’s memory”: https://code.claude.com/docs/en/memory
2. OpenAI, documentación de las memorias de ChatGPT: https://learn.chatgpt.com/docs/customization/memories
3. Laban et al. 2025, “LLMs Get Lost In Multi Turn Conversation”: https://arxiv.org/abs/2505.06120
4. Lance Martin en X, 23 de septiembre de 2026: https://x.com/RLanceMartin/status/2102575471502528989
5. Honour, Lehman, Ali, Abi Fadel, Mechbal et al., “A Scalable Database Management System for Long-Term Institutional Memory, Human-AI Knowledge Sharing, and Contextual Recall” (MaluDB), preprint, 10 de mayo de 2026: https://zenodo.org/records/20114119
6. Mi artículo anterior, “I Spent Almost 4 Years Building with AI. Most of It Was Standing Still.” (25 de septiembre de 2026): https://elcapitano0o.substack.com/p/i-spent-almost-4-years-building-with
7. Tibo Sottiaux en X, 4 de octubre de 2026, los 28 días de lanzamientos: https://x.com/thsottiaux/status/2106845241357824205
8. Mis 8 issues en GitHub, listadas por autor: https://github.com/openai/codex/issues?q=author%3Aotmanm y https://github.com/anthropics/claude-code/issues?q=author%3Aotmanm
9. OpenAI, componentes open source de Codex: https://learn.chatgpt.com/docs/open-source
10. Pull request de Codex 51812, “Enable instant interrupts by default”, fusionada el 7 de octubre de 2026: https://github.com/openai/codex/pull/51812
11. OpenAI, documentación de Dots: https://learn.chatgpt.com/docs/dots
12. OpenAI, arquitectura de la Agents API: https://developers.openai.com/api/docs/guides/agents-api/architecture
13. Anthropic, “A postmortem of three recent issues”, 17 de septiembre de 2025: https://www.anthropic.com/engineering/a-postmortem-of-three-recent-issues
14. OpenAI, “Sycophancy in GPT 4o”, 29 de abril de 2025: https://openai.com/index/sycophancy-in-gpt-4o/
15. Anthony Downs, “Up and Down with Ecology: The Issue Attention Cycle”, The Public Interest, 1972: https://nationalaffairs.com/public_interest/detail/up-and-down-with-ecologythe-issue-attention-cycle
16. Anthropic, plan Max: https://claude.com/blog/max-plan
17. Àlex Rodríguez Bacardit, “The rise of Meat Proxies (and how to disarm them)”, 9 de octubre de 2026: https://www.alexrodba.com/the-rise-of-meat-proxies-and-how-to-disarm-them/
18. Simon Willison sobre los cinco niveles de programación con IA de Dan Shapiro, del autocompletado picante a la fábrica de software a oscuras, 28 de enero de 2026: https://simonwillison.net/2026/Jan/28/the-five-levels/
19. OpenAI Alignment, Auto review: https://alignment.openai.com/auto-review/
20. Cookbook de Anthropic, revisor de repositorios programado con el Claude Agent SDK: https://platform.claude.com/cookbook/claude-agent-sdk-scheduled-repository-reviewer-scheduled-repository-reviewer