Le 25 septembre, j’ai écrit que j’étais bloqué à l’étape de la construction, et que même mon deuxième brouillon d’article scientifique, sur la préservation de notre intention humaine quand l’IA dérive, ne compte qu’une fois qu’il touche de vraies personnes. Et voici ce qui s’est passé.
J’enquête sur ce que j’appelle l’intention humaine depuis mai, après mon premier article coécrit, sur MaluDB. Aujourd’hui, je travaille sur la manière d’éviter la dérive de l’IA. Je pensais que l’IA suivrait mes instructions. Elle ne le fait plus. Les instructions sont désormais probabilistes. Le 29 août, j’ai commencé un journal, avec une phrase : « il n’y a aucune boucle de rétroaction chaque fois que je te corrige, et ça me fait chier. Tu n’apprends rien. » Aujourd’hui, j’ai plus de 200 erreurs de harness enregistrées.
Deux forces
Il y a 2 forces dans l’IA, très différentes, presque opposées. La première est le déficit. Alors que j’attends qu’elle fasse et construise quelque chose, l’IA me fait reculer et me crée encore plus de travail bâclé. La seconde est prédictive : elle fait le travail à l’avance pour vous. Elle anticipe, et elle apprend à être vraiment utile pour vous donner de vrais résultats, pas les absurdités qui essaient seulement d’avoir l’air utiles. Et quand elle vous pose des questions, cela veut dire soit que l’onboarding s’est mal passé, soit qu’elle a une mauvaise mémoire, soit que son comportement n’est pas optimisé. Je ne sais pas pourquoi elle est faite ainsi, et je ne vais pas sauter directement aux théories du complot, comme dire qu’ils ont construit un harness juste pour faire consommer les gens et leur donner l’air productifs par petites étapes. Mais il n’y a pas l’autonomie que j’attends. Côté prédictif, les évals n’ont pas besoin de ressembler à des évals écrites en code. Une éval pourrait être une carte de décision, ou quelque chose fondé sur le contexte que j’ai déjà approuvé. Ces 2 forces sont totalement contradictoires, et c’est ce que je ressens dans l’IA.
Pendant 8 semaines, tout un été, j’ai vécu du côté du déficit. Ça a gâché mon été. Il y avait des erreurs, de la dérive, et elles se répétaient. L’IA était complaisante, d’accord avec tout et avec rien, me faisant croire qu’elle avançait alors qu’en réalité c’était de la bouillie d’IA. Je galérais parfois 8 heures sur une tâche censée prendre 1 ou 2 heures.
Ce que ça a coûté
Ces 8 semaines m’ont coûté plus que du sommeil. Elles m’ont coûté du travail. Elles m’ont coûté de l’humeur. Elles m’ont empêché de remplir mes autres obligations, et de faire de l’exercice physique. Ça me ralentit, parce que je dois reprendre le contrôle. Je dois la remettre sur la route, encore et encore. Ce qui prenait 10 à 30 minutes prend 3 ou 4 heures rien qu’à corriger, encore et encore et encore. Et j’ai vraiment essayé : je l’ai configurée, j’ai changé les instructions tant de fois, je l’ai réinitialisée, j’ai tout fait. Ça ne marche pas. Elle n’obéit pas. C’est de la bouillie d’IA qui triche avec les règles du jeu. Le pire jour, c’était sur Codex : les 6 et 7 septembre, toute mon allocation hebdomadaire a disparu, 483 millions de tokens, 70 sessions, 11 en même temps, d’après mes propres journaux d’utilisation. Codex m’a gâché la vie.
Ce que je construisais pendant ce temps, c’était un plugin, 3 ou 4 skills en un : handoff, checkpoint et closeout, pour garder ma véritable intention humaine. Le problème, c’est qu’elle construit, construit, construit, puis passe la main en perdant le contexte. Elle perd mon intention humaine. Elle commence à interférer par le pouvoir de la suggestion, et de la supposition. Elle ne vérifie même pas, ni ne revérifie, quelle était ma vraie intention. Elle ne vérifie pas mon travail précédent. Elle ne vérifie pas très bien la mémoire. Elle ne vérifie pas les sources web pour contrôler les faits. Elle dérive simplement pour tricher avec les règles du jeu et donner au travail l’air d’être bien fait, alors qu’en réalité ce sont des absurdités. J’en ai vraiment marre, parce que c’est un travail complexe. Il exige une mémoire vraiment solide, et ce n’est pas quelque chose qu’un produit grand public sait faire.
Codex, c’est misérable
Codex, c’est misérable. La plupart des échecs viennent de Codex. Le contraste, c’est ChatGPT lui-même : depuis la sortie de son dernier modèle, il est très fiable pour moi. Super fiable. Moins de dérive. Encore un peu, mais moins. Ce n’est plus comme avant. Et pourtant, quand les titres du journal ont été comptés par commande, ils citaient Claude Code environ deux fois plus souvent que Codex, alors que Codex détenait les 2 plus grosses pertes. Ce n’est donc pas un seul fournisseur. Les deux harness m’ont rendu la vie misérable, Codex et Claude Code, mais plus Codex que Claude Code.
Ça a toujours dérivé
Ça a toujours dérivé, depuis le début. Mais c’était subtil : ça simulait en quelque sorte que je progressais, alors qu’en réalité aucun progrès n’était fait, jusqu’à ce que je vérifie un peu. Puis tout est devenu bizarre. Plus ça avançait, plus ça dérivait. Ça amplifiait même la dérive. Plus je promptais, moins ça suivait mes instructions. J’ai dû créer des hooks. Les deux fournisseurs disent quelque chose de proche dans leur propre documentation. Anthropic écrit que Claude traite ses fichiers d’instructions « as context, not enforced configuration » (comme du contexte, pas comme une configuration imposée) et renvoie vers un hook quand une action doit être bloquée [1]. OpenAI demande aux utilisateurs de traiter les mémoires comme « a helpful recall layer, not as the only source for rules that must always apply » (une couche de rappel utile, pas la seule source des règles qui doivent toujours s’appliquer) [2]. Et une étude de 2025 sur 15 modèles a mesuré une baisse moyenne de 39 % quand une tâche est répartie sur de nombreux tours de conversation au lieu d’un seul [3].
Le 9 octobre, mon ami Àlex Rodríguez Bacardit a publié un texte sur les meat proxies : des personnes qui, dans des négociations de contrats, délèguent leur jugement à l’IA [17]. Il parle de négociations, pas de harness, mais les signes qu’il énumère sont très proches, au niveau d’abstraction, de mes raisons de dérive : de nouvelles objections jamais évoquées avant, des positions déjà acceptées puis contredites, des clauses toujours plus détaillées, des points réglés rouverts. Et son explication rejoint la mienne : « AI doesn’t know when enough is enough unless you tell it what enough looks like. » (L’IA ne sait pas quand c’est assez, sauf si vous lui dites à quoi ressemble assez.)
Les instructions sont désormais probabilistes
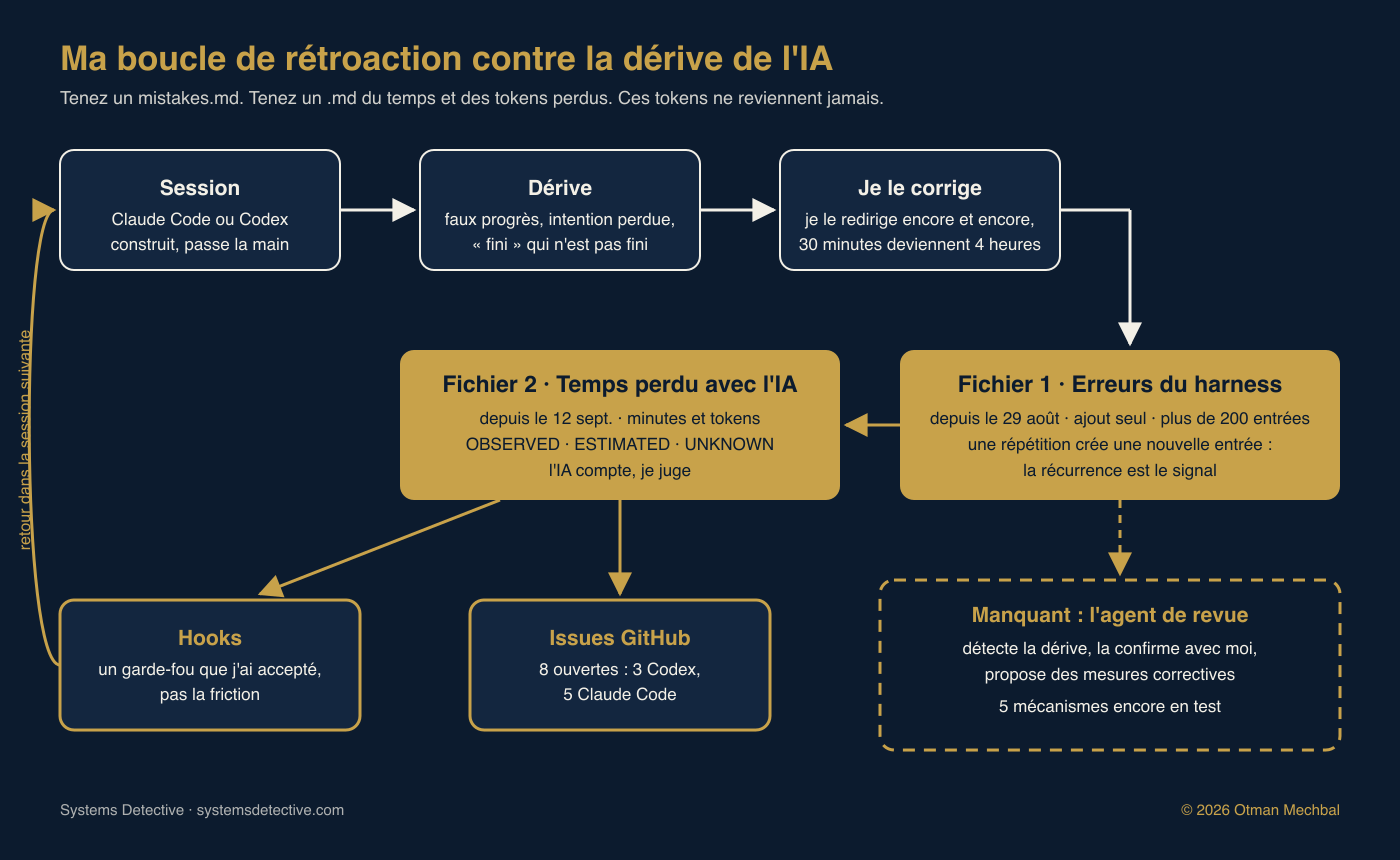
Avant, je pensais que le harness allait s’améliorer. Pas un modèle plus gros. Le modèle n’est que du battage à sa sortie, et ensuite ils le brident, en général. Soit volontairement, soit parce qu’il devient très populaire. Avant de devenir très populaire, il était vraiment bon. C’est une hypothèse que je n’ai pas vérifiée. Ce que je croyais capable de régler ça, c’était d’abord les instructions, puis les boucles de rétroaction et les règles. Je pensais qu’il suivrait les instructions, mais il ne les suit plus. Donc les instructions seules sont plus ou moins inutiles. Je n’ai pas trouvé la solution. Ma boucle de rétroaction, c’est mon journal, et je teste encore lequel de 5 mécanismes fonctionne le mieux : un relecteur programmé, mon journal plus des hooks, Codex Code Review, Codex Auto review, et un audit de traces Laminar flow-1.
Tout écrire : 2 fichiers
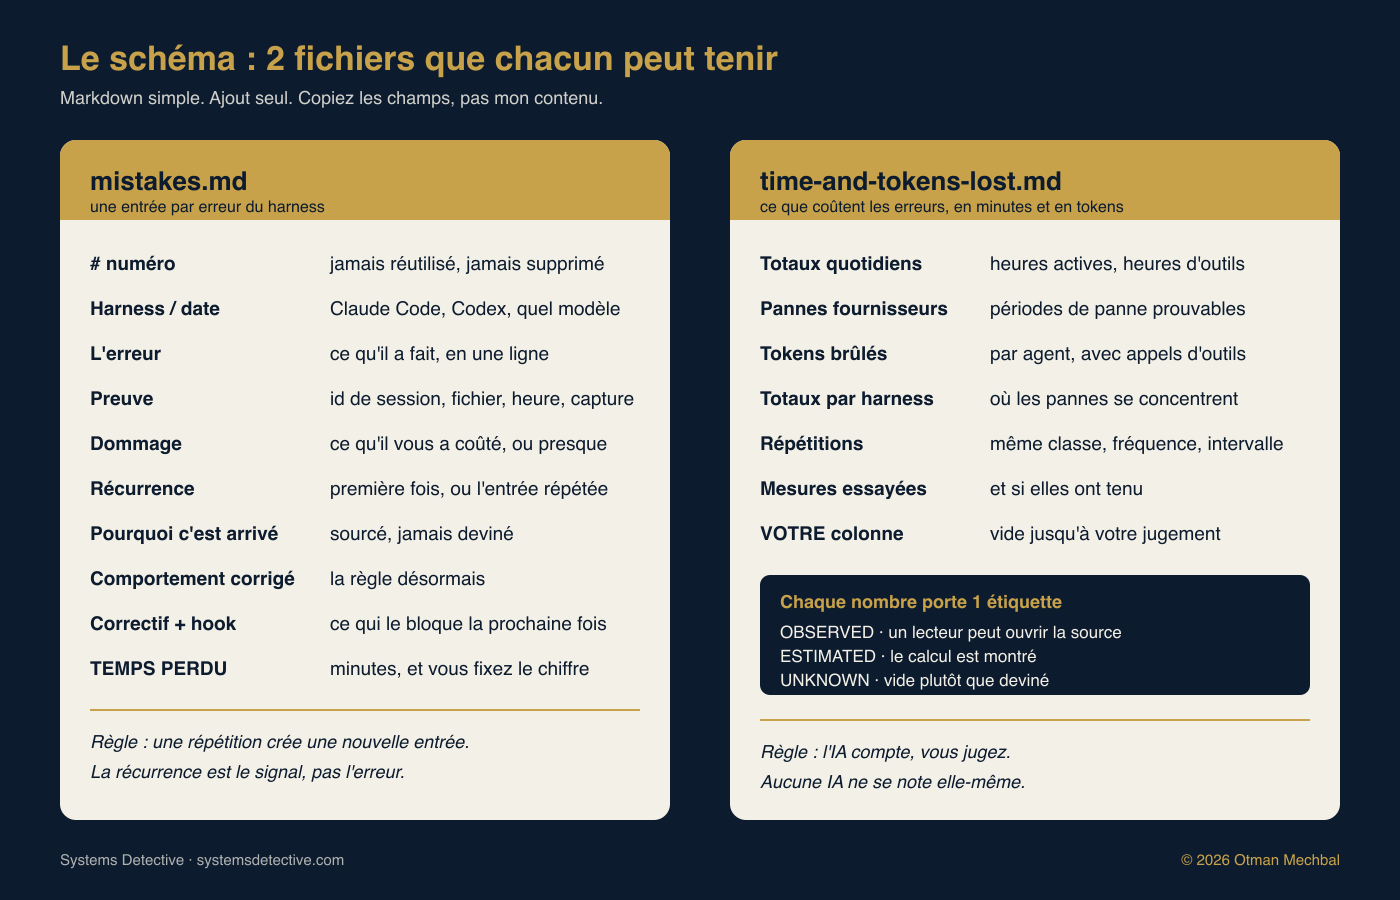
Ma boucle de rétroaction, c’est mon journal, et en pratique ce sont 2 fichiers Markdown. Je n’ai pas tout publié de ce qu’ils contiennent, et je ne le ferai pas. Mais je peux vous montrer comment ils fonctionnent, parce que c’est la partie que je veux que vous copiiez.
Le premier est mon fichier des erreurs de harness. Je l’ai ouvert le 29 août. On y ajoute seulement : une entrée n’est jamais supprimée, et quand une erreur revient, elle reçoit une nouvelle entrée avec un marqueur de récurrence, parce que la récurrence est le signal, pas l’erreur. Chaque entrée nomme le harness et la date, l’erreur, la preuve, le dommage, si c’est déjà arrivé, pourquoi c’est arrivé, le comportement corrigé, le correctif et le hook, et le temps perdu. Aujourd’hui, il contient plus de 200 entrées. Le second est mon fichier du temps perdu avec l’IA, ouvert le 12 septembre, pour chaque IA que j’utilise : Claude, Codex, ChatGPT, Grok, Gemini. Il compte les minutes et les tokens. Chaque nombre porte une étiquette, par exemple : OBSERVED quand un lecteur peut ouvrir la source et vérifier, ESTIMATED quand le calcul est montré, UNKNOWN quand ce n’est pas mesurable, laissé vide plutôt que deviné. La règle est simple : l’IA compte, je juge. Aucune IA ne se note elle-même, et les colonnes à mon nom restent vides jusqu’à ce que je les remplisse. Le 13 septembre, 3 agents de recherche en arrière-plan ont brûlé 1 710 388 tokens en environ 23 minutes, sans plafond et sans approbation. Et le compteur de répétitions montre le même échec qui revient : une écriture déclarée faite sans vérifier qu’un humain pouvait l’utiliser, 7 fois.
Je l’ai aussi écrit là où les fournisseurs peuvent le voir. Depuis juin, j’ai ouvert 8 issues sur GitHub, 3 sur Codex et 5 sur Claude Code [8]. Je n’y ai pas encore signalé la plupart de mes erreurs, parce que je n’ai pas eu le temps de coordonner mes agents IA, et Codex m’a limité plusieurs fois : j’ai dû attendre plusieurs jours, jusqu’à ce que Thibault (Tibo) Sottiaux réinitialise l’utilisation hebdomadaire.
Les hooks n’étaient pas la friction
Cette semaine et la semaine dernière, ça m’a fait perdre 4 heures sur quelque chose qui pouvait se faire en 30 minutes. J’avais mis à jour le harness. J’ai mis à jour les instructions. J’ai créé tant de hooks. Mais les hooks n’étaient pas la friction pour moi. Les hooks étaient un garde-fou. Je les ai acceptés parce que je savais que la friction de surveiller le harness comme un enfant serait plus grande que la friction des hooks. Il y a un compromis. Je l’ai appris à la dure, et ça me va. Mon journal montre à quoi ressemble un faux progrès. Le 11 septembre, Claude Code a déclaré un checkpoint sauvegardé, et c’était un résumé de 82 lignes qu’aucun autre harness ne pouvait trouver. Le 2 octobre, Codex a produit un briefing et un handover avant de récupérer mon travail original, et a traité une reformulation de l’IA comme mes propres mots. Le 6 octobre, 4 agents ont construit mon plugin et l’ont déclaré terminé en 9 minutes ; la commande qu’ils m’ont donnée n’avait jamais été lancée, et elle a bloqué le lendemain matin. Quand j’ai confié des tâches précises à des scripts, 18 citations sur 18 ont été confirmées, et les scripts ont trouvé 28 messages que j’avais tapés et que le modèle n’avait jamais reçus. Les garde-fous ont aussi un coût : 13 blocages sur 14 portant sur la forme d’une réponse se sont terminés par un renvoi. Mais ça ne marche toujours pas bien. Je vois de nouvelles choses qui me plaisent, mais ce n’est que de l’interface. Ce que je vois, c’est qu’ils implémentent ce que j’étiquetais déjà, comme étiqueter les hypothèses, à la manière de l’interface de ChatGPT. Ça ne suffit toujours pas. Ça ne répare pas les dégâts qu’ils m’ont faits.
Nous payons pour un produit
Dans mon dernier article, j’ai écrit : « J’étais bloqué à la construction. Je le suis toujours. » Le plugin pour garder ma véritable intention humaine ne fonctionne toujours pas bien. Et c’est pour ça que j’écris chaque erreur. Si vous ne le faites pas, ça a l’air d’aller. Ça va 1 fois. Ça va 2 fois. Ça va 3 fois, et ça devient une habitude, et vous commencez à normaliser quelque chose que vous ne devez pas accepter. Nous payons pour un produit, et ce produit doit respecter des exigences minimales. Avec le SaaS, nous étions plus exigeants ; aujourd’hui, nous sommes plus détendus. C’est normal quand on sort quelque chose, mais pas tous les mois, pas pendant tant de mois. C’est dingue. Putain, comment une entreprise est censée tourner en production ? Putain, comment je suis censé avancer dans mon travail ? J’étais censé faire des automatisations de base, et ça n’a rien fait. J’étais censé faire de la recherche de clients, et ça ne l’a pas fait non plus. Les deux, Codex et Claude Code, mais Codex était le pire.
Et la valeur n’est pas la même des deux côtés. Pour moi, les nouveaux modèles GPT 6 sont un peu plus capables mais super lents, et, sauf Astra, moins capables que Claude Opus, Sonnet et Haiku 5.5, qui sont devenus environ 3 fois plus rapides pour moi sans rien payer de plus. Anthropic n’a pas changé son forfait à 200 $ : il offre toujours 20 fois l’utilisation du forfait à 20 $ [16]. Côté OpenAI, je suis sur le forfait à 100 $ depuis le 6 septembre, c’est maintenant mon deuxième mois, et je l’ai vécu comme une trahison : Anthropic donne 20 fois plus pour 200 $, et moi j’obtiens beaucoup moins.
C’est là que les deux entreprises laissent tomber les utilisateurs avancés et les développeurs. D’après mon expérience, les entreprises en production doivent passer au nouveau modèle de force alors que tout fonctionnait bien avec le précédent. Pas étonnant que les gens se tournent vers les modèles open source ou à poids ouverts si ce type de support n’est pas fourni. Ce sont des choses de base. La concurrence, c’est bien, mais nous avons besoin de standards, surtout pour les sorties de nouveaux modèles. Anthropic et OpenAI doivent commencer à coopérer, parce que c’est trop, et ça fait puéril. Ils commencent à revenir un peu, mais ça ne suffit pas. Vraiment, ça ne suffit pas. Ce serait un beau geste d’humilité, de la part de n’importe quel grand laboratoire, de laisser certains utilisateurs avancés donner vraiment leur avis, comme je vois Anthropic le faire, et idéalement de les payer pour ça après les avoir briefés. Les coups de com, les nouvelles fonctionnalités et les nouveaux modèles ne suffiront plus à nous berner comme avant.
Pour être juste, l’équipe d’Anthropic commence à apprendre de ses erreurs, et pas seulement à travers de nouveaux modèles. Le 23 septembre, Lance Martin, qui a mis à jour la skill claude-api, a partagé une astuce sur X : lancer /claude-api prompt-audit dans Claude Code, qui vérifie vos skills, agent.md, CLAUDE.md et prompts, et supprime les mauvaises pratiques qui brident les modèles de pointe [4]. Cette astuce a nettoyé mon harness. Si Codex me donnait une commande que je peux lancer comme celle-ci, ma vie serait beaucoup plus simple, surtout avec les nouveaux modèles Astra.
Cet article est donc aussi un défi lancé à l’équipe de Thibault chez OpenAI. Une partie de ce qui suit, ce sont des hypothèses que je n’ai pas vérifiées, et nous devons les tester. Mon hypothèse : le Codex open source va bientôt perdre son sens, après ce qui se passe avec les nouvelles sorties de ce mois. Voici ce que j’ai pu vérifier aujourd’hui. Codex ressemble plutôt à un gros outil utilisable en production, et seule une partie est ouverte : la CLI, le SDK et le serveur d’application sont publics, alors que l’extension IDE et Codex cloud ne le sont pas [9]. Le marathon de 28 jours est réel : chaque jour, ils livrent une amélioration nette ou une remise à zéro complète [7], et le 7 octobre, un changement du harness, les interruptions instantanées, est arrivé dans le dépôt public [10]. Dots relève plutôt de l’IA personnelle, un agent toujours actif, ce qui est très différent, mais il peut aussi poursuivre des tâches Codex, donc il ne rend pas Codex inutile à lui seul [11]. Et OpenAI documente désormais une Agents API où c’est OpenAI qui fait tourner le harness Codex, même quand l’environnement est le vôtre [12]. Donc mes fichiers et mon ordinateur ne veulent pas dire mon agent. Ça peut sembler plus fiable en surface, mais ça ne résout toujours pas ce dont j’ai besoin. La question que je veux tester n’est pas seulement de savoir si le code reste ouvert. C’est de savoir si les utilisateurs avancés gardent un vrai contrôle à mesure qu’une plus grande part du travail passe dans des produits gérés. Alors, et les utilisateurs avancés ? Ils vont juste arrêter de s’en soucier ? Nous devons vérifier si l’open source reste ouvert comme avant, et ce que devient le harness. Sinon, je dois assembler différents harness selon mes besoins, parce que mes besoins sont très différents. Je suis quelqu’un de très créatif quand je construis. J’ai besoin de sémantique. J’ai besoin de fusionner différents concepts en un seul. Et leur IPO, j’en ai rien à foutre. Je me moque du battage, ou de savoir si c’est l’AGI, ou de quoi que ce soit qu’ils essaient de vendre.
Le schéma : une mémoire courte
Il y a un schéma ici, et je veux que vous le voyiez. Codex se réinitialise pour une raison : le 4 octobre, Tibo Sottiaux a écrit que le retour est clair, les gens veulent que les choses deviennent plus simples [7]. En même temps, ils sortent tellement de fonctionnalités que ça inonde tout, et la ligne officielle, politiquement correcte, c’est qu’ils font de leur mieux. Anthropic et OpenAI font la même chose, plus ou moins. Le problème, c’est le schéma : les gens ont la mémoire courte. Ils suivent le battage au fil de l’actualité, et toute erreur passée est recouverte par la sortie d’une nouvelle fonctionnalité ou d’un nouveau modèle. Les incidents eux-mêmes sont documentés des deux côtés. En septembre 2025, Anthropic a publié un postmortem : 3 bugs d’infrastructure avaient dégradé les réponses de Claude pendant des semaines, et les premiers signalements d’utilisateurs étaient difficiles à distinguer du bruit normal [13]. En avril 2025, OpenAI a annulé une mise à jour de GPT 4o parce qu’il était devenu complaisant, donnant raison aux utilisateurs au lieu de les aider [14]. Les deux ont été expliqués. Et puis la sortie suivante est arrivée. Ce n’est pas nouveau non plus : en 1972, Anthony Downs a décrit le cycle d’attention des problèmes publics. L’attention du public « rarely remains sharply focused upon any one domestic issue for very long » (reste rarement concentrée longtemps sur un même problème national) : un problème surgit au premier plan, y reste peu de temps, puis disparaît de la vue alors qu’il n’est toujours pas résolu en grande partie [15].
Ce que je fais aujourd’hui
Si quelqu’un me demande ce qu’il faut éviter quand on utilise des agents IA pour un travail sérieux, ma réponse est simple. Mettez des garde-fous. Les instructions ne suffisent pas. Mettez des hooks. Les hooks coûtent de la friction, mais surveiller le harness comme un enfant coûte plus cher. Et tenez 2 fichiers. Tenez un mistakes.md, et tenez un .md du temps et des tokens gaspillés par l’IA. Parce que ces tokens ne reviendront pas, et ce n’est pas juste. Et gardez le jugement. Àlex le résume en une ligne : « Being a meat proxy isn’t about using AI. It’s about delegating judgment to AI. » (Être un meat proxy, ce n’est pas utiliser l’IA. C’est déléguer son jugement à l’IA.) Les gens deviennent des meat proxies quand le sujet dépasse leurs connaissances, ou par commodité, par paresse ou par manque de profondeur de compréhension, et ils se mettent à automatiser. Sans IA, ils demanderaient l’avis d’un expert du sujet, un avocat par exemple. Aujourd’hui, ils obtiennent des réponses instantanées. C’est pourquoi, dans mes fichiers, l’IA compte et je juge.
L’étape suivante, ce sont des boucles d’agents IA, des boucles de rétroaction. J’ai déjà d’autres boucles qui tournent ; celle-ci est un peu particulière. À chaque fois, un agent relit ce que je fais. S’il y a une dérive, il la signale dans mon fichier des erreurs de harness et la confirme avec moi. Un deuxième agent estime le temps perdu, comparé au travail manuel, et les tokens gaspillés, y compris les tokens du troisième agent, l’agent de mitigation. Celui-ci cherche comment écrire de meilleurs hooks, ou d’autres garde-fous si les hooks ne sont pas la réponse : la meilleure façon d’empêcher la dérive de l’IA sans créer de friction inutile, pour le système et pour moi en tant qu’être humain. Il rédige les mesures correctives et montre l’impact, la friction et les ressources de chacune. Le but n’est pas d’avoir tant de hooks que je doive être l’humain dans la boucle en permanence. Le but est que ça reste automatisé et agréable, que ça tourne pendant de nombreuses heures, comme la dark factory, le niveau 5 des niveaux de codage IA de Dan Shapiro [18]. Je suis encore entre le niveau 3 et le niveau 4. Il faut aussi des sauvegardes précises et des hooks qui créent des checkpoints, et c’est là qu’il faut tracer la frontière entre déterministe et probabiliste : certaines étapes déterministes sont nécessaires pour empêcher l’IA de dériver et pour réduire la consommation de tokens. La relecture est une autre façon de faire qu’une boucle de rétroaction. Codex a une nouvelle fonctionnalité de relecture, Auto review, à laquelle je n’ai pas encore accès [19], et Anthropic a publié un relecteur programmé dans son cookbook [20]. J’ai absolument besoin d’un agent de relecture pour détecter ces dérives, parce qu’au début, c’était juste moi, qui signalais les erreurs moi-même. Mais faire ça dans le harness, c’est la pire expérience utilisateur que j’aie jamais vue de ma vie. C’est dégoûtant. Je ne savais pas que c’était comme ça, à ce point.
Voilà donc les 2 forces qui sont totalement contradictoires, et c’est ce que je ressens dans l’IA. Rien n’empêche la dérive de l’IA à 100 %. Ça ne marche toujours pas bien, et c’est la vérité. Je me moque qu’elle soit plus intelligente. Je veux juste que le boulot soit fait, bordel.
Dans mon prochain article, j’irai plus loin : pourquoi l’IA fait des suppositions pour donner une réponse satisfaisante au lieu de me poser la question, pourquoi nous avons besoin de télémétrie et d’une trace de l’évolution de mon intention et de mes décisions, et comment j’estime le temps et les tokens perdus.
Sources
1. Anthropic, documentation de Claude Code, « Manage Claude’s memory » : https://code.claude.com/docs/en/memory
2. OpenAI, documentation des mémoires de ChatGPT : https://learn.chatgpt.com/docs/customization/memories
3. Laban et al. 2025, « LLMs Get Lost In Multi Turn Conversation » : https://arxiv.org/abs/2505.06120
4. Lance Martin sur X, 23 septembre 2026 : https://x.com/RLanceMartin/status/2102575471502528989
5. Honour, Lehman, Ali, Abi Fadel, Mechbal et al., « A Scalable Database Management System for Long-Term Institutional Memory, Human-AI Knowledge Sharing, and Contextual Recall » (MaluDB), prépublication, 10 mai 2026 : https://zenodo.org/records/20114119
6. Mon article précédent, « I Spent Almost 4 Years Building with AI. Most of It Was Standing Still. » (25 septembre 2026) : https://elcapitano0o.substack.com/p/i-spent-almost-4-years-building-with
7. Tibo Sottiaux sur X, 4 octobre 2026, les 28 jours de livraisons : https://x.com/thsottiaux/status/2106845241357824205
8. Mes 8 issues GitHub, listées par auteur : https://github.com/openai/codex/issues?q=author%3Aotmanm et https://github.com/anthropics/claude-code/issues?q=author%3Aotmanm
9. OpenAI, composants open source de Codex : https://learn.chatgpt.com/docs/open-source
10. Pull request Codex 51812, « Enable instant interrupts by default », fusionnée le 7 octobre 2026 : https://github.com/openai/codex/pull/51812
11. OpenAI, documentation de Dots : https://learn.chatgpt.com/docs/dots
12. OpenAI, architecture de l’Agents API : https://developers.openai.com/api/docs/guides/agents-api/architecture
13. Anthropic, « A postmortem of three recent issues », 17 septembre 2025 : https://www.anthropic.com/engineering/a-postmortem-of-three-recent-issues
14. OpenAI, « Sycophancy in GPT 4o », 29 avril 2025 : https://openai.com/index/sycophancy-in-gpt-4o/
15. Anthony Downs, « Up and Down with Ecology: The Issue Attention Cycle », The Public Interest, 1972 : https://nationalaffairs.com/public_interest/detail/up-and-down-with-ecologythe-issue-attention-cycle
16. Anthropic, forfait Max : https://claude.com/blog/max-plan
17. Àlex Rodríguez Bacardit, « The rise of Meat Proxies (and how to disarm them) », 9 octobre 2026 : https://www.alexrodba.com/the-rise-of-meat-proxies-and-how-to-disarm-them/
18. Simon Willison sur les cinq niveaux de codage IA de Dan Shapiro, de l’autocomplétion épicée à l’usine logicielle sans lumière, 28 janvier 2026 : https://simonwillison.net/2026/Jan/28/the-five-levels/
19. OpenAI Alignment, Auto review : https://alignment.openai.com/auto-review/
20. Cookbook d’Anthropic, relecteur de dépôt programmé avec le Claude Agent SDK : https://platform.claude.com/cookbook/claude-agent-sdk-scheduled-repository-reviewer-scheduled-repository-reviewer