Pueden explicarte un informe, ordenar una cronología o ayudarte a preparar preguntas para un médico. El problema es enviar tu identidad y tu contexto privado cuando ese servicio tan cómodo quizá solo necesite una parte de la información médica. Antes de subir nada, hay 4 razones para eliminar lo que el sistema no necesita.
1. Tu vulnerabilidad puede convertirse en una señal de venta. Los datos de salud no se limitan a describir una afección; pueden mostrar tus miedos y lo que quizá te desespere resolver. Si un servicio detecta ansiedad por la fertilidad, el cáncer, el peso, el dolor crónico, la salud sexual o un resultado inusual, esa señal puede usarse para dirigirte anuncios de suplementos, pruebas, suscripciones o productos “milagro” justo cuando eres más vulnerable. El caso BetterHelp de la FTC demostró que esto no es teórico. El regulador alegó que se divulgó a plataformas publicitarias información sensible de un cuestionario, a pesar de las promesas de privacidad. ¿Le contarías a sabiendas a un anunciante tus síntomas y tus miedos antes de ver qué quiere venderte?
2. Tus datos pueden influir en cómo te puntúan las instituciones a tus espaldas. La información de salud puede afectar a las evaluaciones de riesgo. Según el país, el producto y el marco jurídico, podría influir en el precio de los seguros, en la suscripción de pólizas, en las reclamaciones o en la elegibilidad. El Reglamento Europeo de IA (AI Act) clasifica como de alto riesgo la IA usada para la evaluación de riesgos y la fijación de precios en los seguros de vida y de salud. Un sistema también puede interpretar mal un medicamento antiguo, confundir una afección temporal con una crónica o crear un perfil inferido, basado en suposiciones, que no puedes ver ni corregir. ¿Podría el servicio conservar o transmitir información que más tarde influya en una decisión importante?
3. Una brecha de ciberseguridad le da a un atacante algo más que tu nombre. Los documentos clínicos suelen contener fechas de nacimiento, direcciones, datos del seguro, números de historia clínica, nombres de clínicas, citas, medicamentos e información familiar. Estos datos pueden facilitar la suplantación de identidad médica, el robo de cuentas o el phishing sofisticado. Las historias clínicas figuran entre los datos más valiosos de la dark web, y los datos robados suelen aparecer a la venta entre 24 y 48 horas después de una brecha. Un atacante que conozca a tu proveedor sanitario y tu próxima cita puede hacerse pasar por un hospital, una farmacia o una aseguradora con mucha más eficacia que un estafador genérico. El 26 de junio de 2026, un asociado comercial del sector sanitario notificó al Departamento de Salud y Servicios Humanos de EE. UU. un incidente de hackeo de un servidor que afectó a más de 1,2 millones de personas. Si el servicio fuera hackeado mañana, ¿qué podría reconstruir alguien a partir de lo que subiste hoy y con qué rapidez podría revenderse?
4. Tus datos pueden tener una “segunda vida”. Aunque no todos los proveedores de IA entrenan con todas las interacciones, “no se usa para entrenar” no cuenta toda la historia. La información aún puede conservarse en registros, revisarse por motivos de seguridad, ser tratada por subcontratistas, incluirse en analíticas o usarse para mejorar el producto. También existe un mercado directo de reventa: los intermediarios de datos compran y venden activamente información de salud, y no es algo teórico. Unos investigadores que contactaron con 37 intermediarios de datos sobre datos de salud mental encontraron 11 vendedores dispuestos a ofrecer listas de personas con depresión, ansiedad o historial de medicación para el TEPT, dentro de una industria estadounidense de unos 200.000 millones de dólares que no cuenta con ninguna ley federal específica que la regule. La FTC ha advertido a las empresas de IA de que usar datos de clientes para entrenar modelos en contra de sus compromisos puede generar responsabilidad legal. Una vez que la información de salud se copia entre sistemas o se vende a un intermediario, borrar una conversación puede no borrar todas las copias posteriores. Deberías preguntar: qué se conserva, quién puede revisarlo, qué encargados del tratamiento lo reciben, si se vende a un intermediario y si una solicitud de supresión llega a todos ellos.
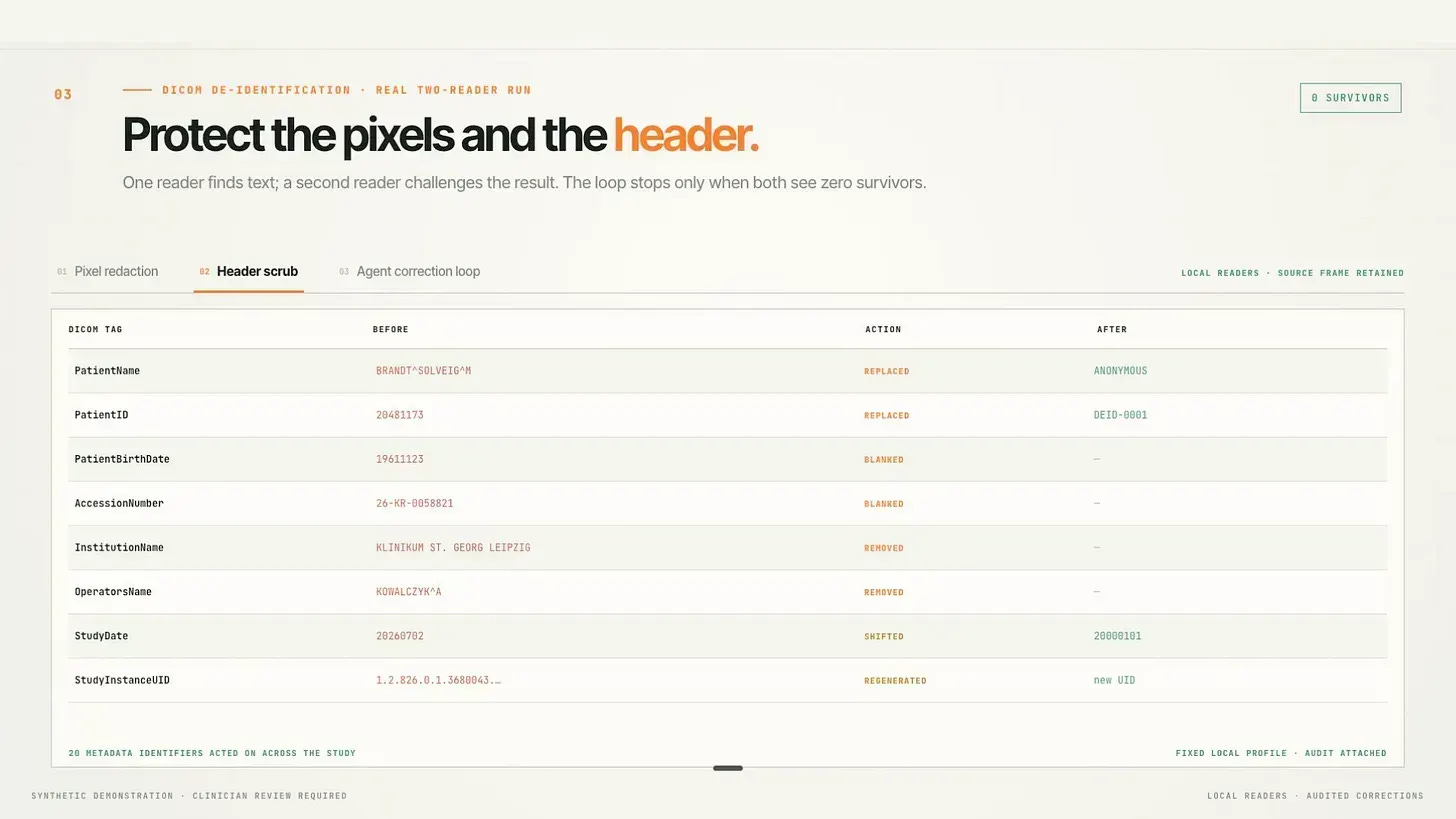
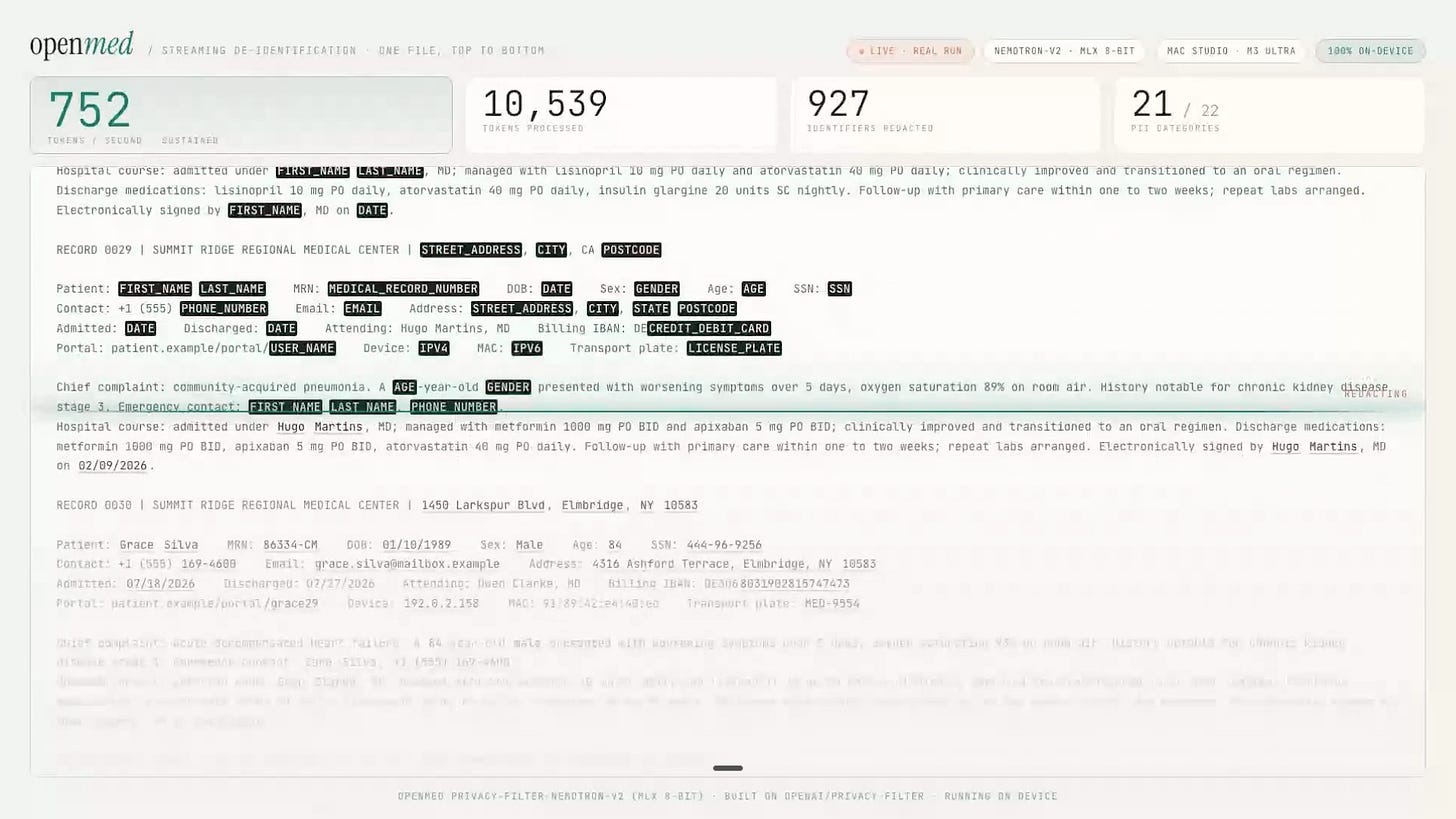
Quitar simplemente un nombre suele no bastar. Una nota de salud puede identificar a alguien por fechas exactas, lugares, enfermedades poco frecuentes o relaciones familiares. La guía del HHS reconoce que incluso la información de salud desidentificada conserva un pequeño riesgo de reidentificación, y su método “Safe Harbor” exige eliminar muchas categorías además de los nombres. Si eliminas muy poco, sigues siendo identificable; si eliminas demasiado, la nota pierde su valor clínico. Las fechas son especialmente difíciles porque son necesarias para una cronología clínica, pero también pueden revelar la identidad.
Este reto inspiró la primera herramienta de código abierto que construí: github.com/otmanm/health-data-anonymiser, un anonimizador local de notas de salud. El flujo de trabajo era estrecho por diseño: limpiar la nota en tu equipo, revisar el resultado y solo entonces compartir los datos concretos necesarios. Más tarde descubrí OpenMed, iniciado por Maziyar Panahi, una plataforma avanzada de IA sanitaria con prioridad local, y aporté correcciones para el desplazamiento de fechas, la conservación del formato y flujos de trabajo sin conexión más seguros. El objetivo no era resolver todo el problema con un solo prototipo, sino reducir la cantidad de datos sensibles que cruzan límites innecesarios.
Antes de subir información de salud, pregunta: ¿qué tarea exacta realiza el sistema? ¿Qué identificadores hacen falta? ¿Qué se queda en mi dispositivo? ¿Cuánto tiempo se conservan los datos? ¿Se usan para entrenamiento o publicidad? ¿Se pueden borrar por completo? La comodidad siempre tiene un precio, sobre todo cuando los datos que hacen fácil usar una herramienta pueden acabar volviéndose en tu contra. Con unos incidentes de ciberseguridad cada vez más frecuentes, es vital pensárselo dos veces antes de compartir información sensible con laboratorios de IA.
Usa las herramientas cuando te ayuden, pero aporta solo la información mínima necesaria. La mejor forma de proteger tu privacidad es sencilla: no compartas nada que no necesites compartir en absoluto.
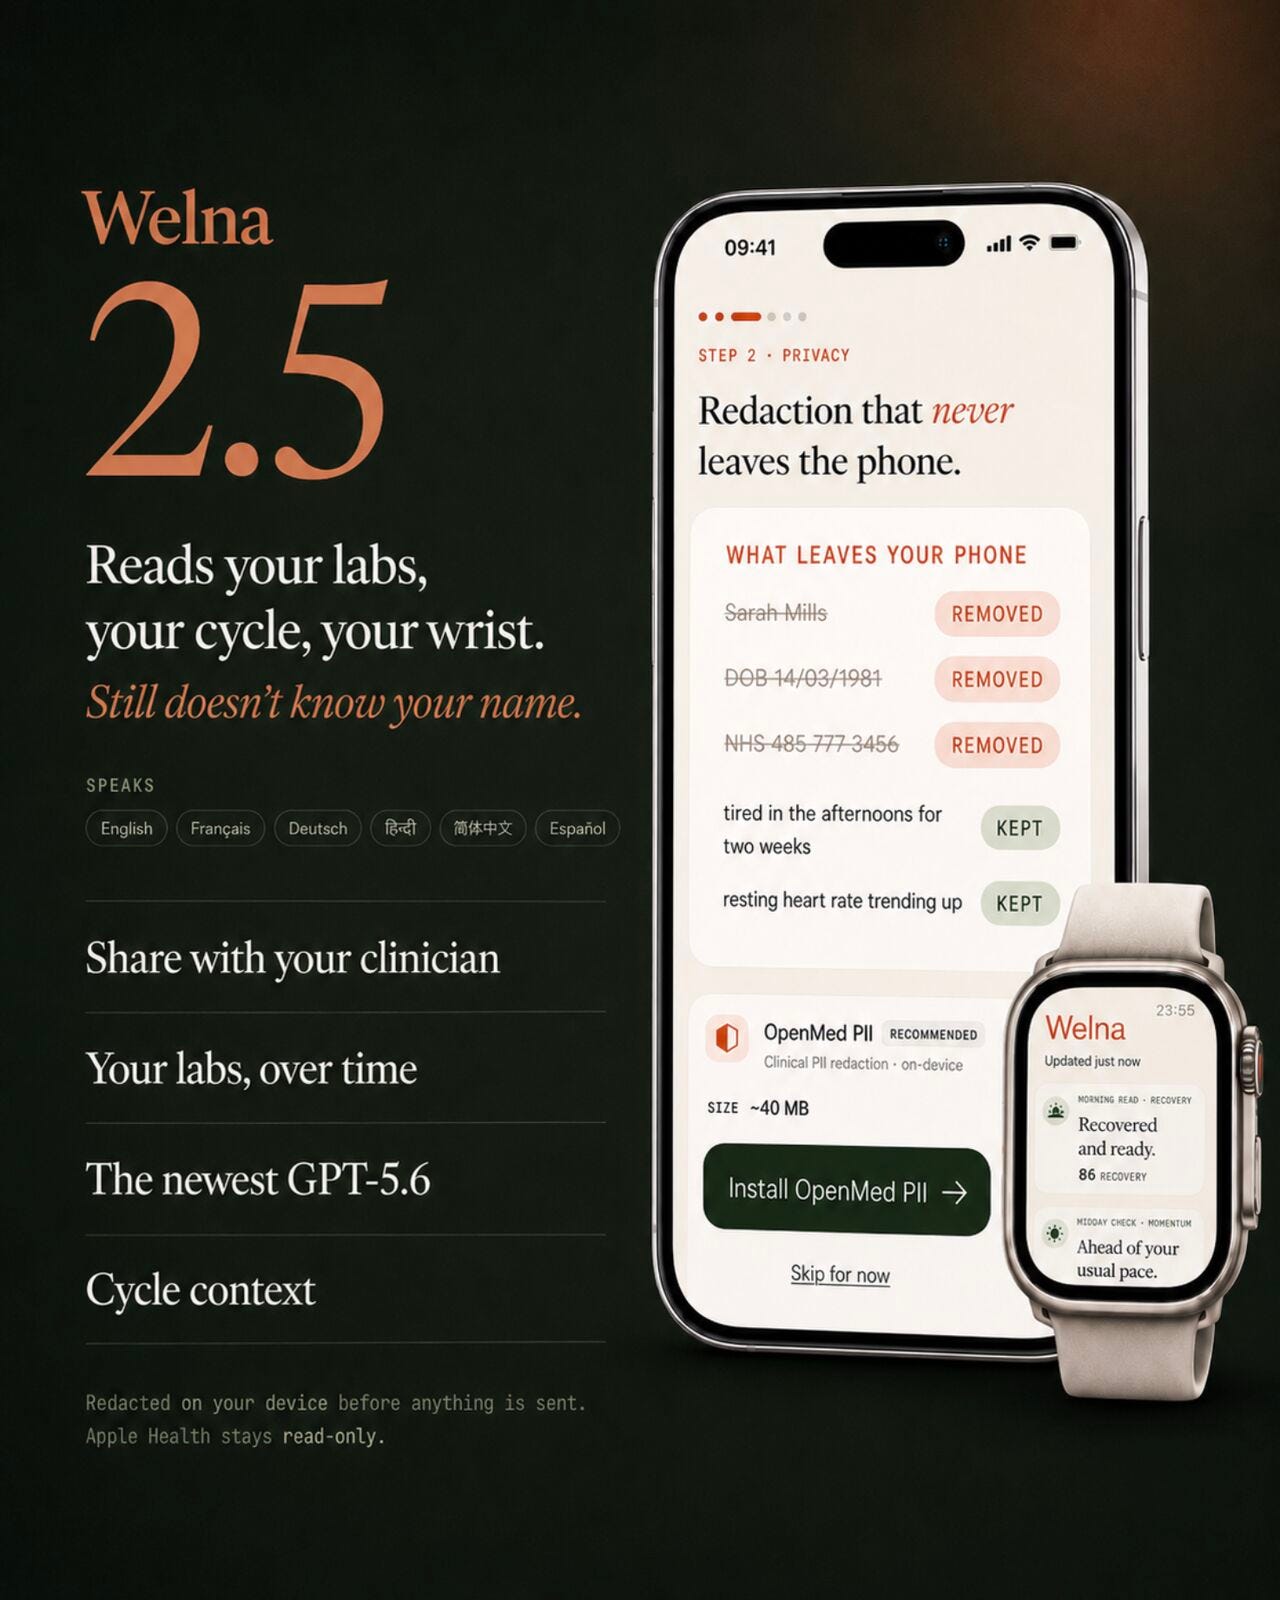
Si buscas una forma más segura de usar IA sanitaria, plantéate probar OpenMed. Para quienes prefieren una configuración sin tecnicismos, puedes descargar la app de OpenMed directamente desde la App Store o visitar su web en openmed.life para empezar con un enfoque de prioridad local. A diferencia de las apps de IA basadas en la nube, que almacenan tus datos en otro lugar, esta solución hace que tu información de salud nunca salga de tu dispositivo y permanezca a salvo.
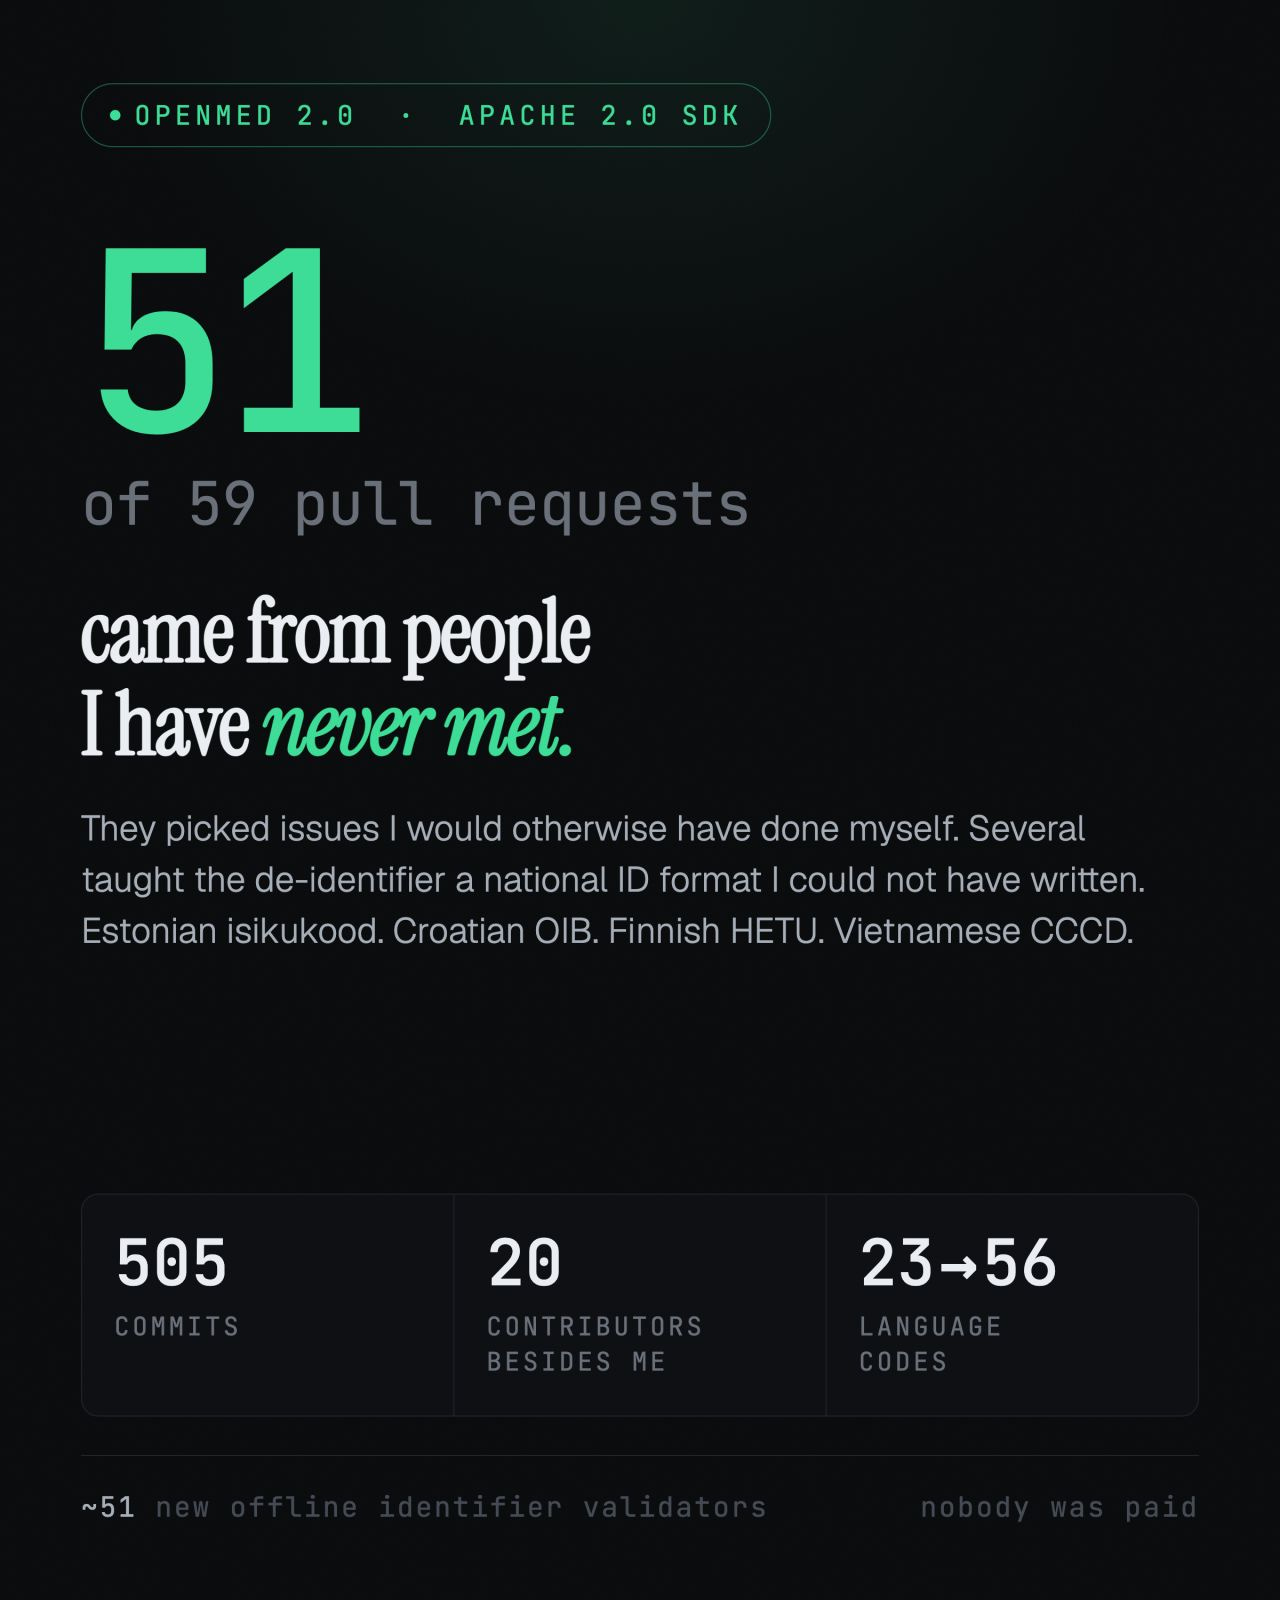
Por último, si eres de los que construyen y quieres mejorar tus habilidades de vibe coding o sumarte a proyectos de código abierto útiles y centrados en resolver problemas humanos que importan, puedes unirte a la comunidad.
Fuentes
[1] Federal Trade Commission, “FTC Gives Final Approval to Order Banning BetterHelp from Sharing Sensitive Health Data for Advertising”, 2023. La FTC alegó que BetterHelp divulgó datos de cuestionarios de salud y otra información personal a plataformas publicitarias a pesar de sus promesas de privacidad.
[2] European Commission, “Navigating the AI Act”. La Comisión identifica la IA usada para la evaluación de riesgos y la fijación de precios en los seguros de vida y de salud entre los casos de uso de alto riesgo del Reglamento.
[3] US Department of Health and Human Services, Office for Civil Rights, Breach Portal. El portal recoge un incidente de hackeo de un servidor de red de MCBS, LLC notificado el 26 de junio de 2026, que afectó a 1.261.464 personas.
[4] Federal Trade Commission, “AI Companies: Uphold Your Privacy and Confidentiality Commitments”, 2024. La FTC advierte a los proveedores contra el uso de datos de clientes con fines no divulgados, como entrenar o actualizar modelos en contra de sus compromisos.
[5] US Department of Health and Human Services, “Guidance Regarding Methods for De-identification of Protected Health Information”. El HHS explica los métodos Safe Harbor y Expert Determination y afirma que los datos correctamente desidentificados siguen conllevando un pequeño riesgo de identificación distinto de cero.
[6] Flare, “What is the Cost of Your Data on the Dark Web?” Las historias clínicas figuran entre las categorías de datos robados de mayor valor y suelen aparecer en los mercados de la dark web entre 24 y 48 horas después de una brecha.
[7] Duke Sanford Tech Policy program, estudio que contactó con 37 intermediarios de datos sobre datos de salud mental; 11 de las 26 empresas que respondieron estaban dispuestas a venderlos, en un mercado estadounidense sin regular que se estima en 200.000 millones de dólares.