Ils peuvent expliquer un rapport, organiser une chronologie ou aider à préparer des questions pour un médecin. Le problème, c’est d’envoyer votre identité et votre contexte privé alors que ce service pratique n’aurait besoin que d’une partie des informations médicales. Avant de téléverser quoi que ce soit, il y a 4 raisons de retirer ce dont le système n’a pas besoin.
1. Votre vulnérabilité peut devenir un signal commercial. Les données de santé ne se contentent pas de décrire une pathologie ; elles peuvent montrer vos peurs et ce que vous cherchez peut-être désespérément à résoudre. Si un service détecte de l’anxiété liée à la fertilité, au cancer, au poids, à une douleur chronique, à la santé sexuelle ou à un résultat inhabituel, ce signal peut servir à vous cibler avec des publicités pour des compléments, des tests, des abonnements ou des produits « miracles » au moment où vous êtes le plus vulnérable. L’affaire BetterHelp de la FTC a montré que ce n’est pas théorique. Le régulateur a allégué que des informations sensibles issues d’un questionnaire avaient été communiquées à des plateformes publicitaires malgré des promesses de confidentialité. Diriez-vous en connaissance de cause à un annonceur vos symptômes et vos peurs avant de voir ce qu’il veut vous vendre ?
2. Vos données peuvent influencer la façon dont des institutions vous évaluent dans votre dos. Les informations de santé peuvent peser sur les évaluations du risque. Selon le pays, le produit et le cadre juridique, elles pourraient avoir un effet sur la tarification des assurances, la souscription, les sinistres ou l’éligibilité. Le règlement européen sur l’IA (AI Act) classe comme à haut risque l’IA utilisée pour l’évaluation du risque et la tarification en assurance vie et santé. Un système peut aussi mal interpréter un ancien médicament, confondre une pathologie temporaire avec une pathologie chronique, ou créer un profil déduit, fondé sur des hypothèses, que vous ne pouvez ni voir ni corriger. Le service pourrait-il conserver ou transmettre des informations qui influenceront plus tard une décision importante ?
3. Une faille de cybersécurité donne à un attaquant bien plus que votre nom. Les documents cliniques contiennent souvent des dates de naissance, des adresses, des informations d’assurance, des numéros de dossier médical, des noms de cliniques, des rendez-vous, des médicaments et des informations familiales. Ces données peuvent faciliter l’usurpation d’identité médicale, la prise de contrôle de comptes ou un hameçonnage sophistiqué. Les dossiers de santé figurent parmi les données les plus précieuses du dark web, et les données volées apparaissent généralement à la vente dans les 24 à 48 heures qui suivent une violation. Un attaquant qui connaît votre prestataire de soins et votre prochain rendez-vous peut se faire passer pour un hôpital, une pharmacie ou un assureur bien plus efficacement qu’un escroc quelconque. Le 26 juin 2026, un partenaire d’affaires du secteur de la santé a signalé au Département américain de la Santé et des Services sociaux (HHS) un piratage de serveur touchant plus de 1,2 million de personnes. Si le service était piraté demain, que pourrait-on reconstituer à partir de ce que vous avez téléversé aujourd’hui, et à quelle vitesse cela pourrait-il être revendu ?
4. Vos données peuvent avoir une « seconde vie ». Même si tous les fournisseurs d’IA n’entraînent pas leurs modèles sur chaque interaction, « non utilisé pour l’entraînement » ne dit pas tout. Les informations peuvent quand même être conservées dans des journaux, examinées pour des raisons de sécurité, traitées par des prestataires, intégrées à des analyses ou utilisées pour améliorer le produit. Il existe aussi un marché direct de revente : des courtiers en données achètent et vendent activement des informations de santé, et ce n’est pas théorique. Des chercheurs qui ont contacté 37 courtiers en données au sujet de données de santé mentale ont trouvé 11 vendeurs prêts à vendre des listes de personnes ayant un historique de traitement contre la dépression, l’anxiété ou le TSPT, dans une industrie américaine d’environ 200 milliards de dollars, sans loi fédérale dédiée pour l’encadrer. La FTC a averti les entreprises d’IA que l’utilisation des données de clients pour entraîner des modèles, en contradiction avec leurs engagements, peut engager leur responsabilité juridique. Une fois que les informations de santé sont copiées entre des systèmes, ou vendues à un courtier, supprimer une conversation ne supprime peut-être pas toutes les copies en aval. Il faut demander : qu’est-ce qui est conservé, qui peut le consulter, quels sous-traitants le reçoivent, est-ce vendu à un courtier, et une demande de suppression les atteint-elle tous ?
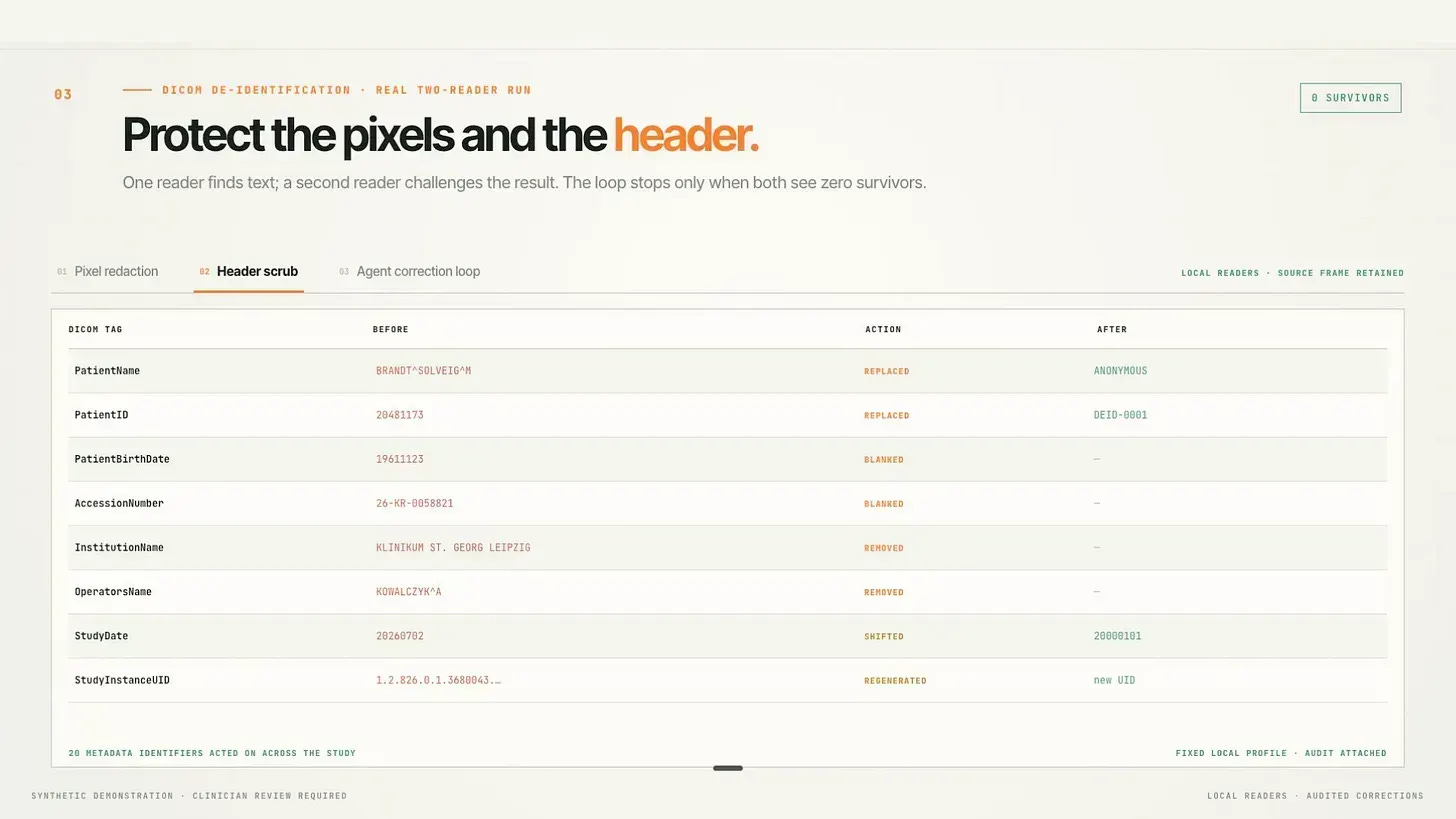
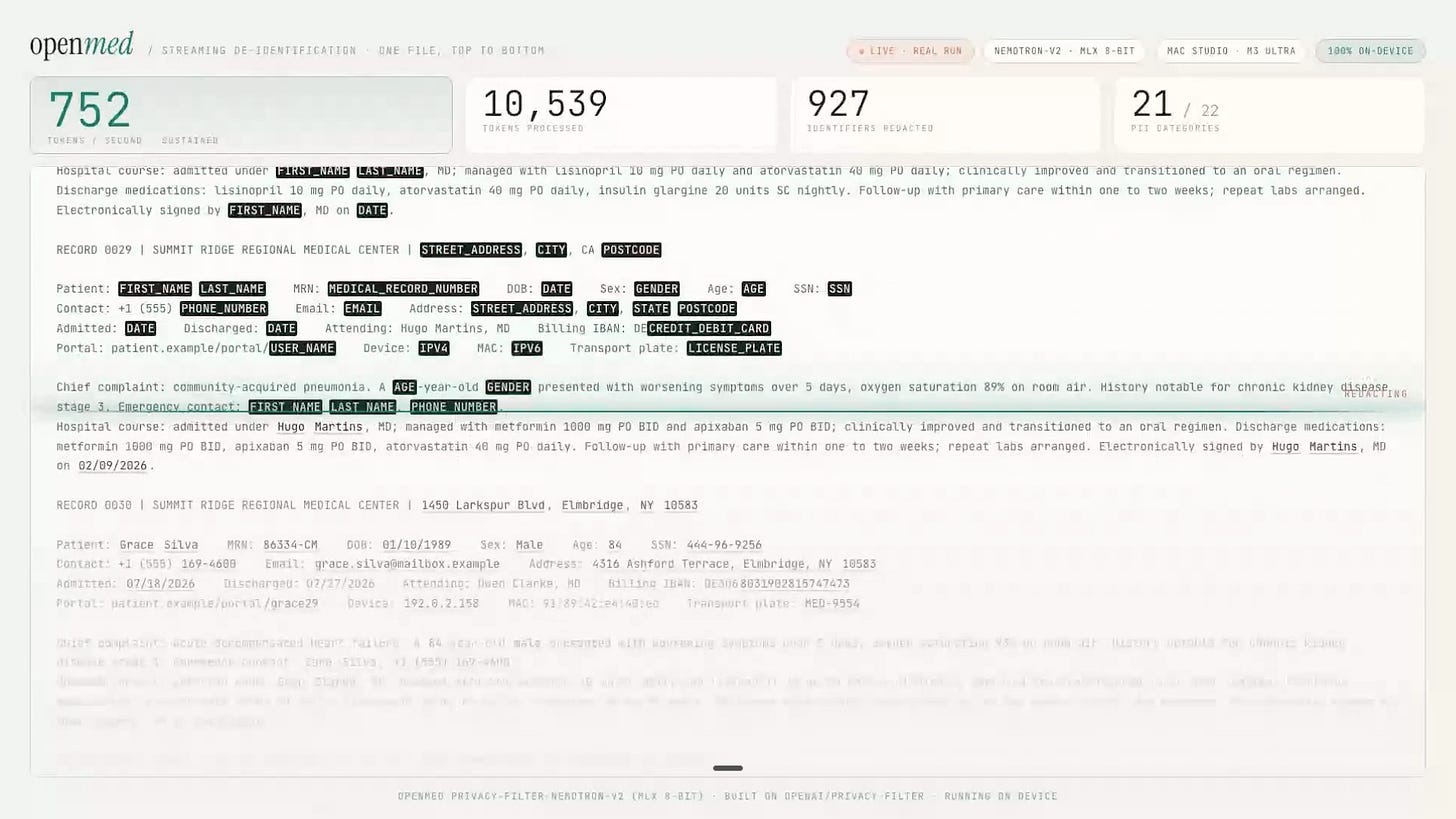
Retirer simplement un nom ne suffit souvent pas. Une note de santé peut identifier quelqu’un par des dates exactes, des lieux, des pathologies rares ou des liens familiaux. Les recommandations du HHS reconnaissent que même des informations de santé désidentifiées conservent un faible risque de réidentification, et sa méthode « Safe Harbor » exige de retirer de nombreuses catégories en plus des noms. Retirez trop peu, et vous restez identifiable ; retirez trop, et la note perd sa valeur clinique. Les dates sont particulièrement délicates, car elles sont nécessaires à une chronologie clinique mais peuvent aussi révéler une identité.
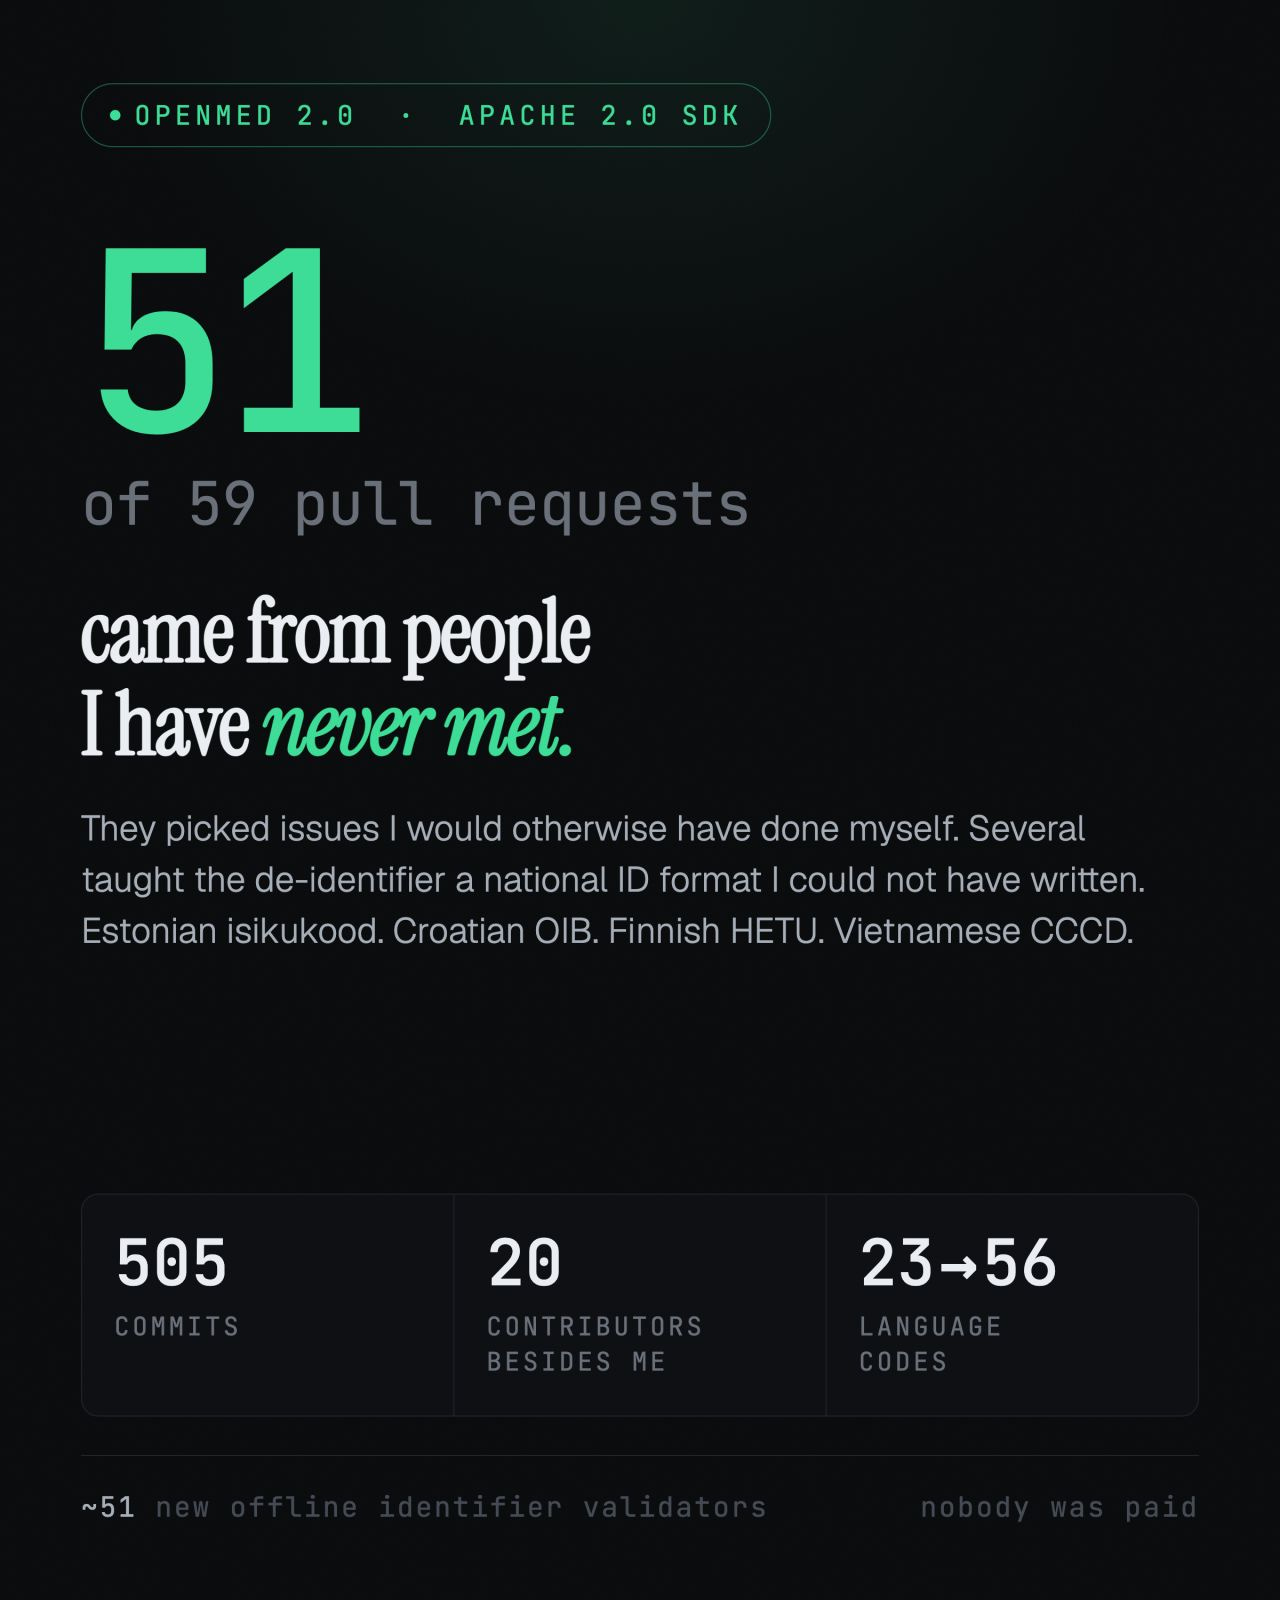
Ce défi a inspiré le premier outil open source que j’ai construit : github.com/otmanm/health-data-anonymiser, un anonymiseur local de notes de santé. Le flux de travail était étroit par conception : nettoyer la note sur votre machine, vérifier le résultat, et seulement ensuite partager les données précises nécessaires. Plus tard, j’ai découvert OpenMed, lancé par Maziyar Panahi, une plateforme d’IA de santé avancée qui privilégie le traitement en local, et j’ai contribué des correctifs pour le décalage des dates, la préservation des formats et des flux hors ligne plus sûrs. L’objectif n’était pas de résoudre tout le problème avec un seul prototype, mais de réduire la quantité de données sensibles qui franchissent des limites inutiles.
Avant de téléverser des informations de santé, demandez : quelle tâche précise le système effectue-t-il ? Quels identifiants sont nécessaires ? Qu’est-ce qui reste sur mon appareil ? Combien de temps les données sont-elles conservées ? Sont-elles utilisées pour l’entraînement ou la publicité ? Peuvent-elles être supprimées complètement ? La commodité a toujours un prix, surtout quand les données qui rendent un outil facile à utiliser peuvent plus tard être retournées contre vous. Les incidents de cybersécurité devenant plus fréquents, il est essentiel d’y réfléchir à deux fois avant de partager des informations sensibles avec des laboratoires d’IA.
Utilisez des outils quand ils aident, mais ne fournissez que le minimum d’informations nécessaire. La meilleure façon de protéger votre vie privée est simple : ne partagez rien dont vous n’avez pas absolument besoin.
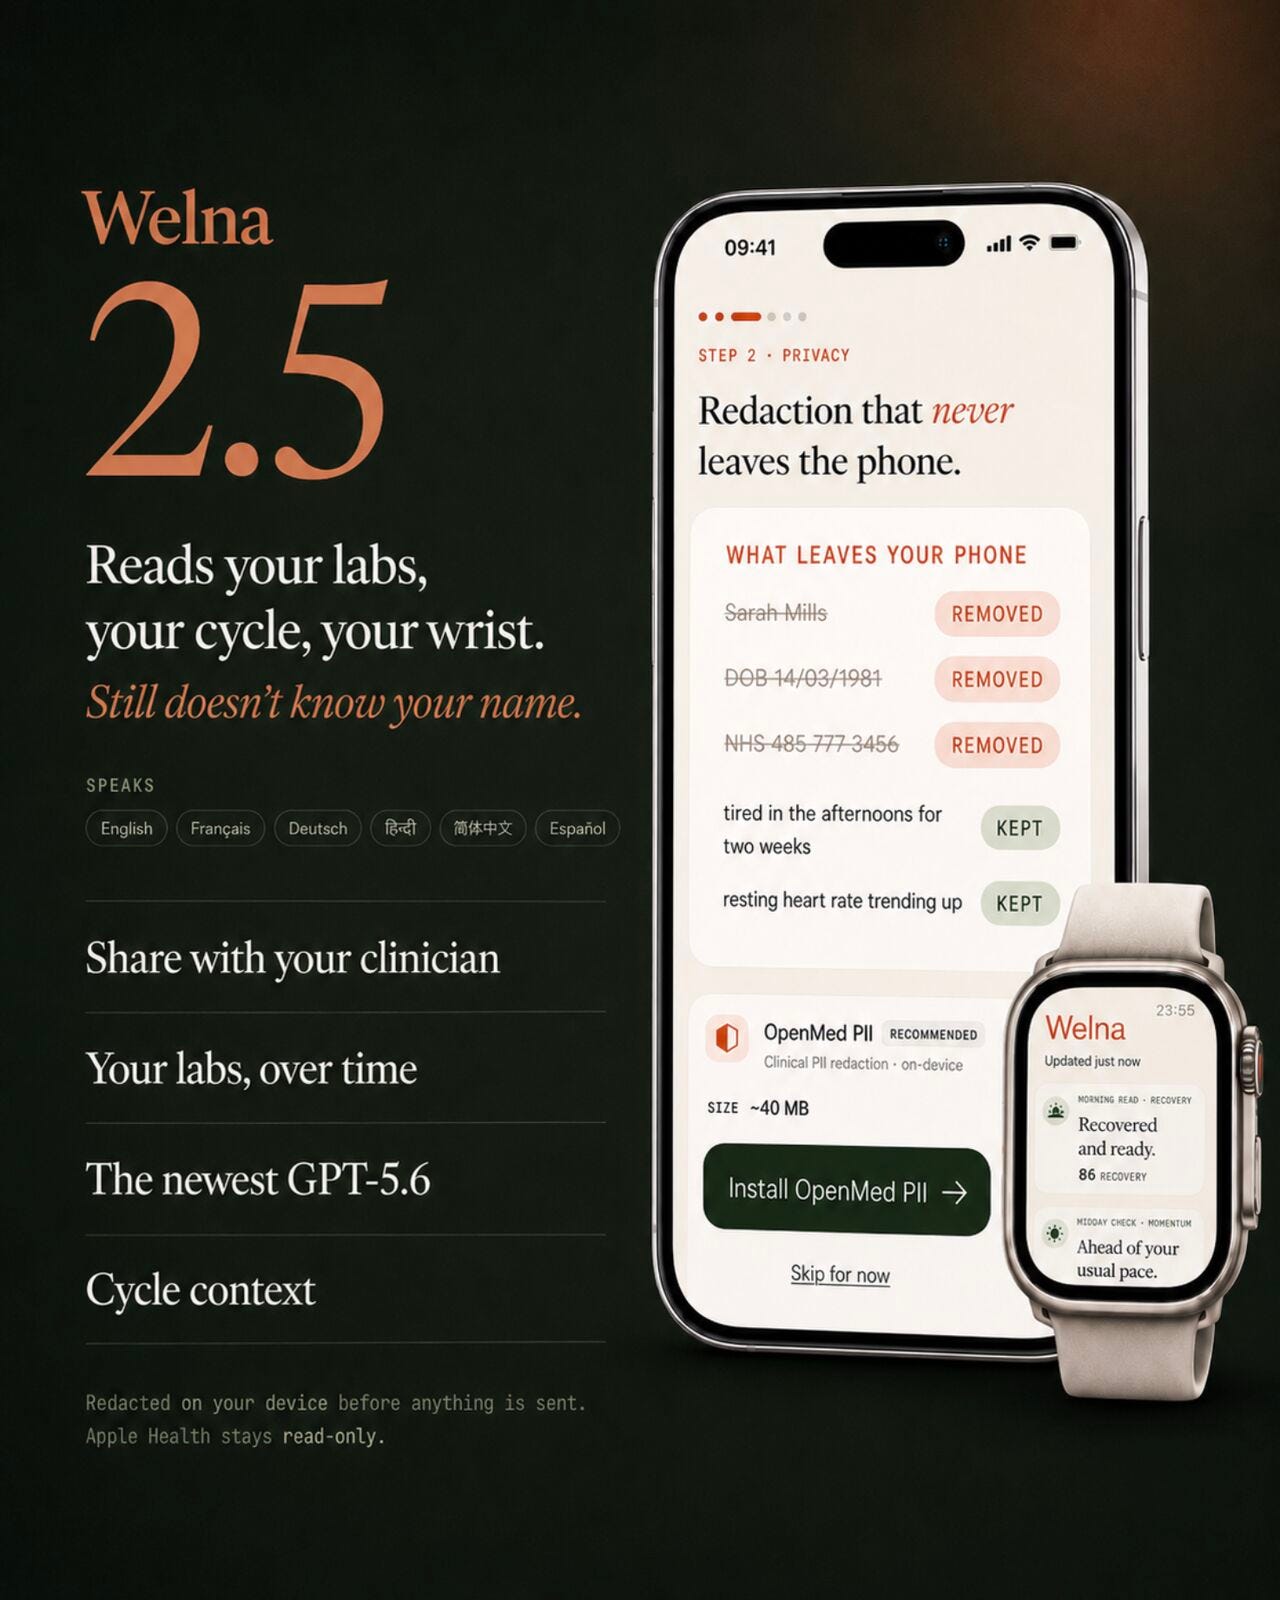
Si vous cherchez une façon plus sûre d’utiliser l’IA de santé, envisagez d’essayer OpenMed. Pour ceux qui préfèrent une installation sans compétences techniques, vous pouvez télécharger l’application OpenMed directement depuis l’App Store ou visiter leur site openmed.life pour démarrer avec une approche qui privilégie le traitement en local. Contrairement aux applications d’IA hébergées dans le cloud, qui stockent vos données ailleurs, cette solution garantit que vos informations de santé ne quittent jamais votre appareil et restent en sécurité.
Enfin, si vous construisez des choses et voulez améliorer votre pratique du vibe coding ou rejoindre des projets open source, utiles et centrés sur la résolution de problèmes humains qui comptent, vous pouvez rejoindre la communauté.
Sources
[1] Federal Trade Commission, « FTC Gives Final Approval to Order Banning BetterHelp from Sharing Sensitive Health Data for Advertising », 2023. La FTC a allégué que BetterHelp avait communiqué des données de questionnaires de santé et d’autres informations personnelles à des plateformes publicitaires malgré ses promesses de confidentialité.
[2] European Commission, « Navigating the AI Act ». La Commission recense l’IA utilisée pour l’évaluation du risque et la tarification en assurance vie et santé parmi les cas d’usage à haut risque du règlement.
[3] US Department of Health and Human Services, Office for Civil Rights, Breach Portal. Le portail répertorie un incident de piratage de serveur réseau de MCBS, LLC, déclaré le 26 juin 2026, touchant 1 261 464 personnes.
[4] Federal Trade Commission, « AI Companies: Uphold Your Privacy and Confidentiality Commitments », 2024. La FTC met en garde les fournisseurs contre l’utilisation des données de clients à des fins non divulguées, comme l’entraînement ou la mise à jour de modèles, en contradiction avec leurs engagements.
[5] US Department of Health and Human Services, « Guidance Regarding Methods for De-identification of Protected Health Information ». Le HHS explique les méthodes Safe Harbor et Expert Determination et indique que des données correctement désidentifiées comportent toujours un risque d’identification faible mais non nul.
[6] Flare, « What is the Cost of Your Data on the Dark Web? » Les dossiers de santé figurent parmi les catégories de données volées les plus valorisées et apparaissent généralement sur les marchés du dark web dans les 24 à 48 heures qui suivent une violation.
[7] Programme Duke Sanford Tech Policy, étude ayant contacté 37 courtiers en données au sujet de données de santé mentale ; 11 des 26 entreprises ayant répondu étaient prêtes à les vendre, sur un marché américain non réglementé estimé à 200 milliards de dollars.